做一支 3 分鐘 AI 動畫,生成費用約 US$196
這支約三分鐘的盜賊動畫,影片生成費用約 US$196。從八十次生成與重抽紀錄,談小團隊如何先試拍一個 beat,再補故事,分配世界觀、previz、提示詞和剪輯的工作。
做這支約三分鐘的 AI 動畫,影片生成費用約 US$196。 Seedance 2.5 生成畫面,Claude Code 與 Codex 協助前製和 Blender previz,最後由團隊負責剪輯。這次經驗讓我們更確定:預算需要容納試作,但無止境重抽只是繼續幫助字節跳動成為更偉大的公司。
盜賊動畫完整成片,長 2 分 52 秒。本文的價格對應這支作品;追求更精細的表演、連戲與畫面品質,還需要追加製作預算。
這個金額按本次購買方案的實際用量折算,只計影片生成;圖片生成、軟體訂閱與人工另計。
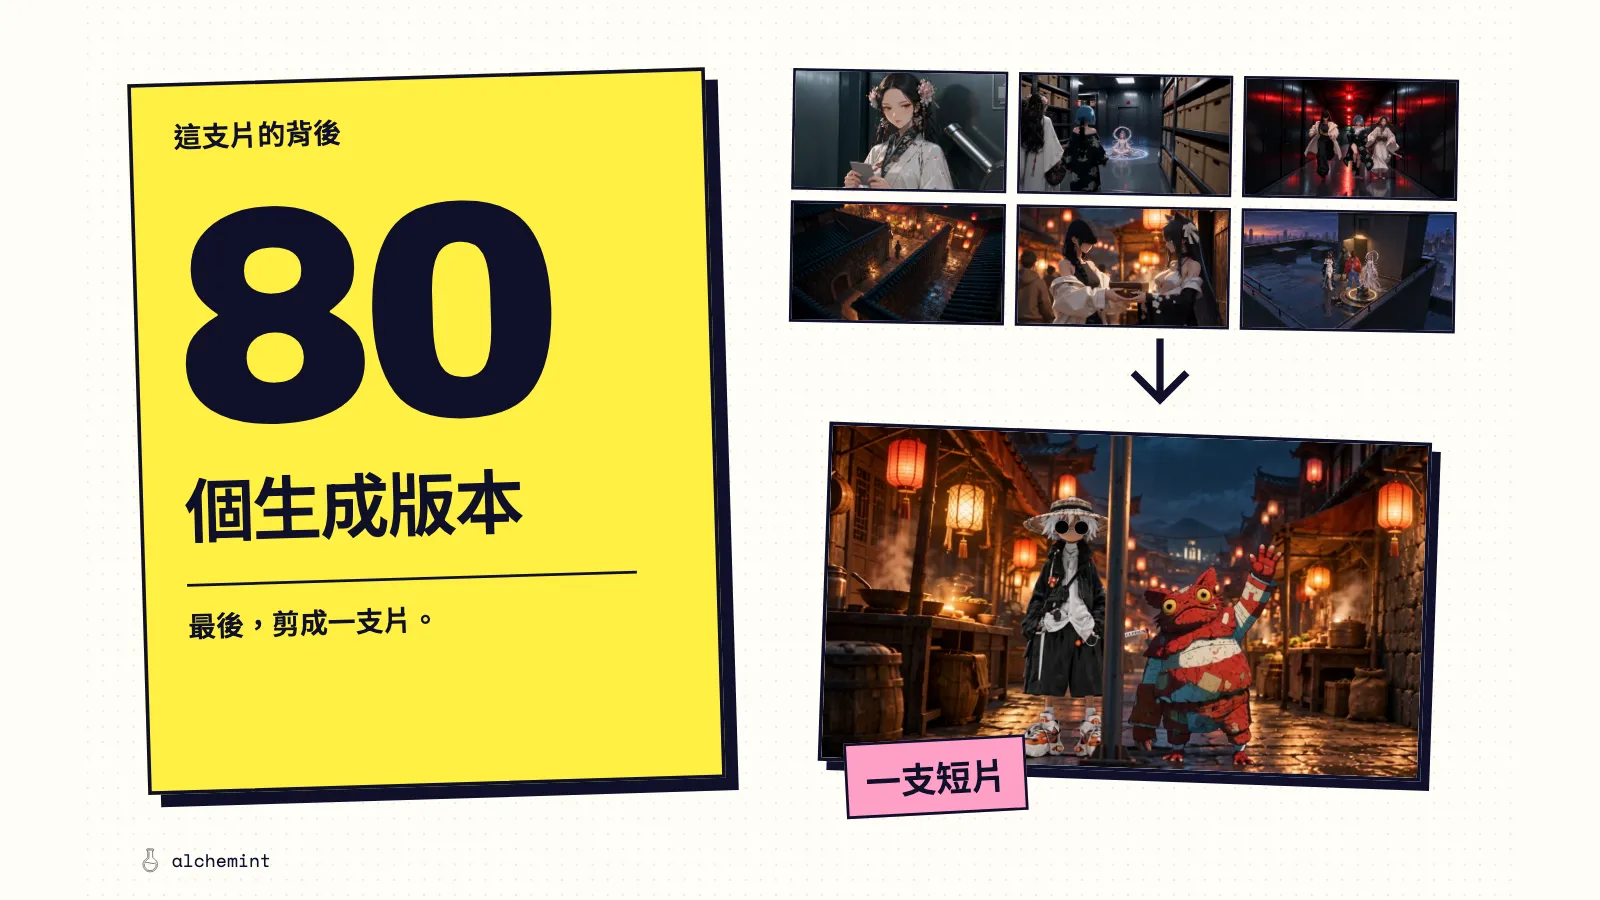
三分鐘成片,背後生成了二十一分鐘素材
整個系列製作期間,共有 80 次成功的影片生成,各版本合計超過 21 分鐘。我從這些素材中挑選、裁切,才得到上面的成片。
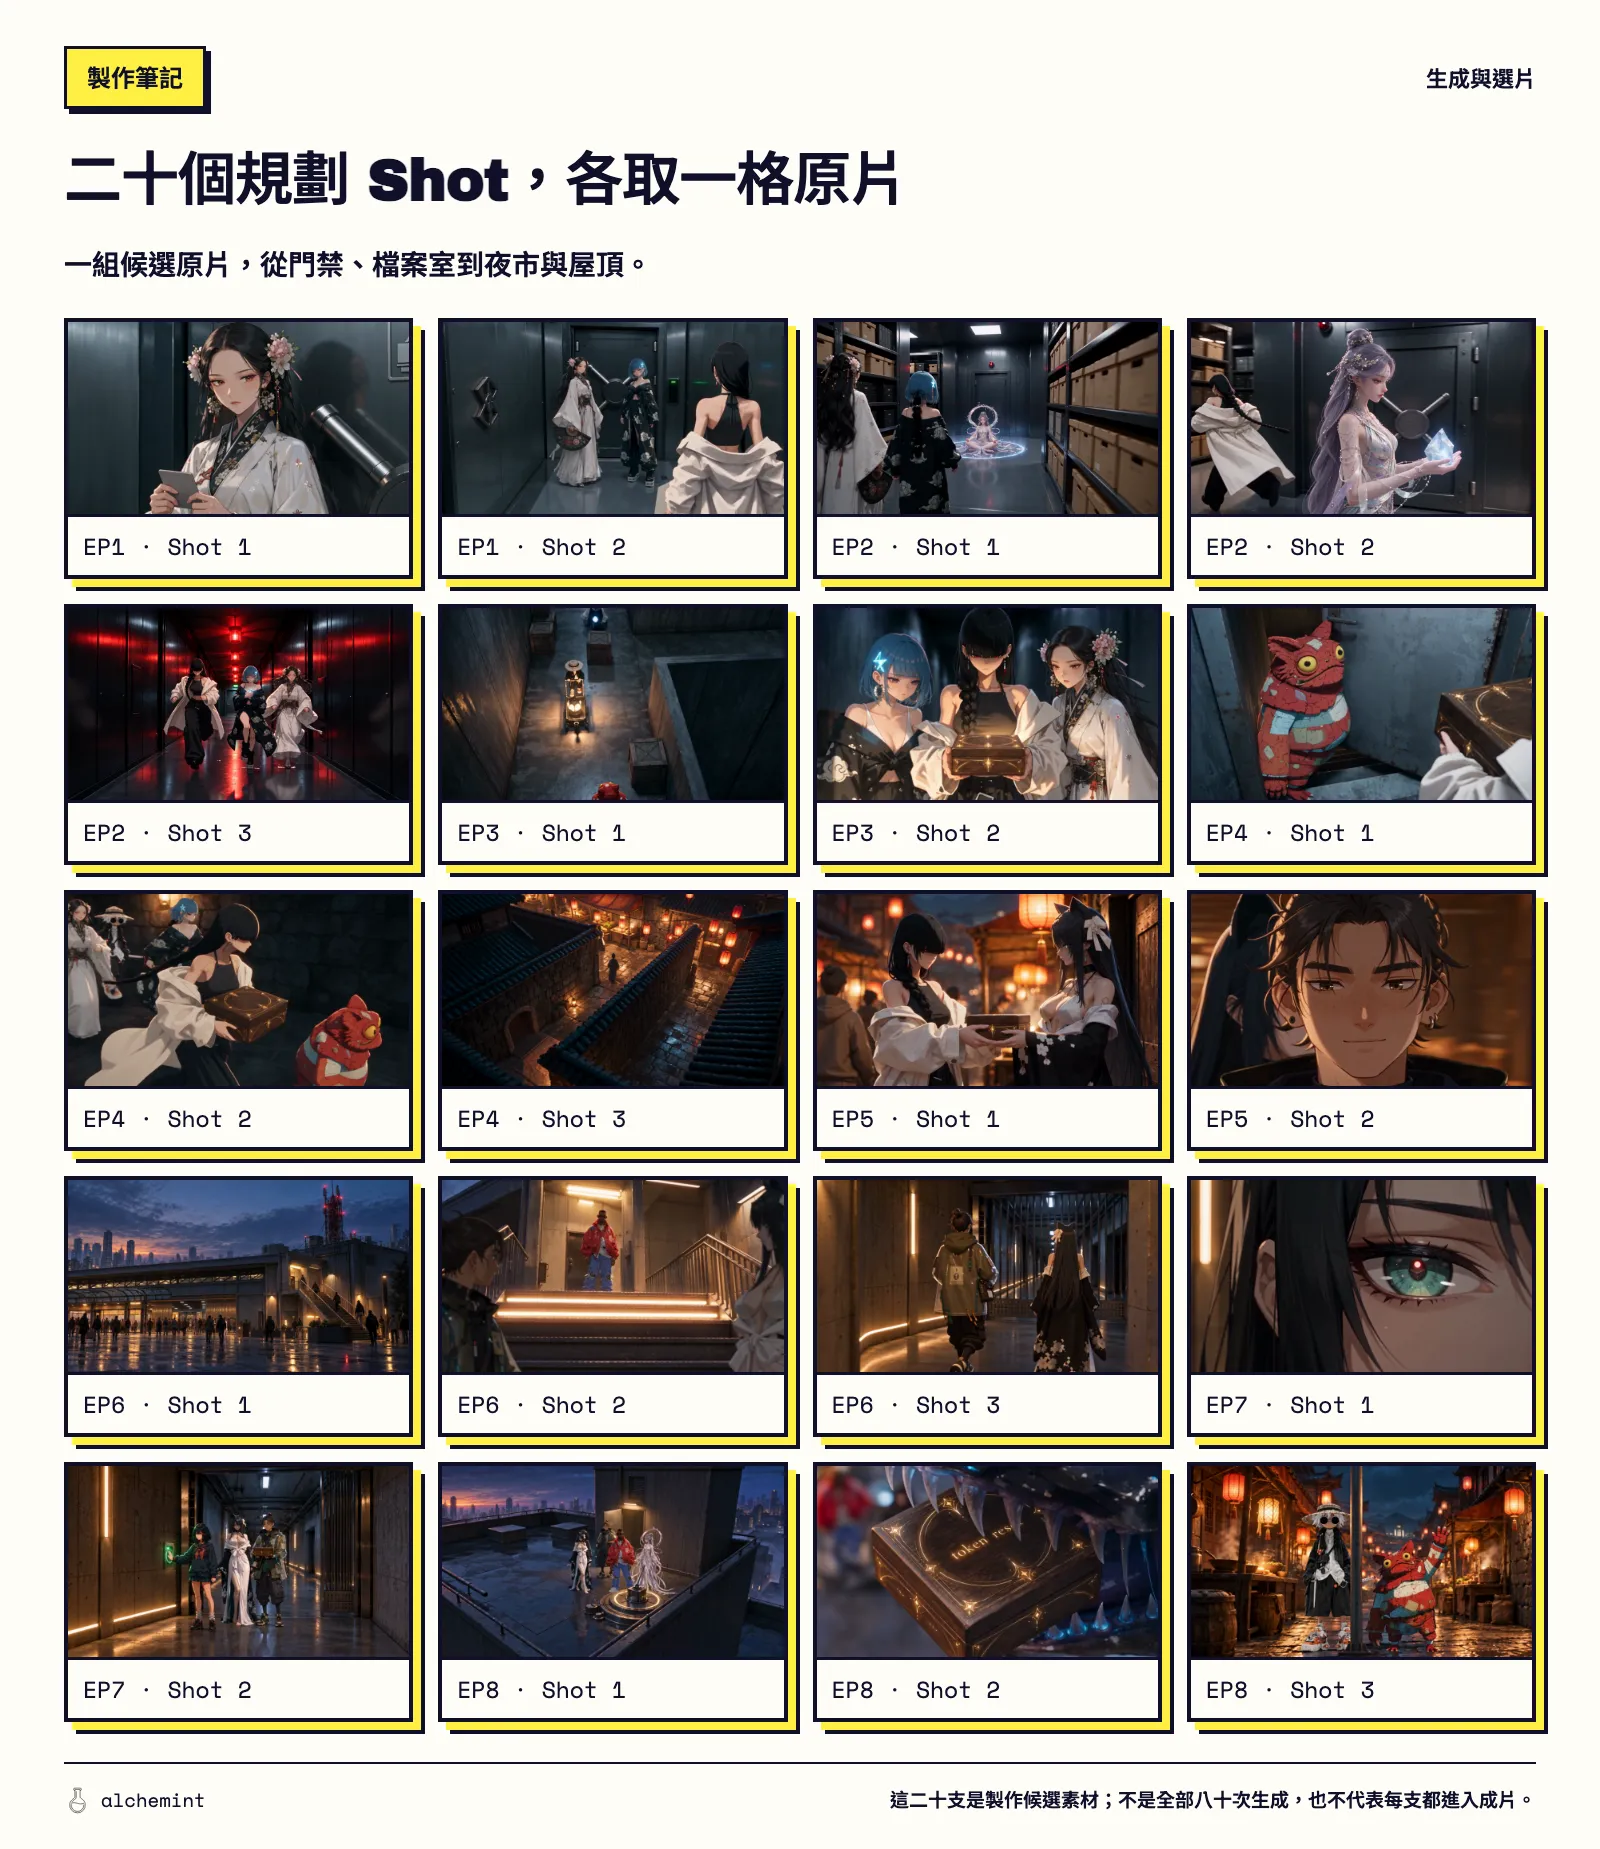
這是一組製作候選原片的縮圖,不是全部八十次生成;其中有些片段未進入成片。
那些多出來的版本,有些用來探索故事,有些更動人物安排或鏡位,也有些是上一版沒有演出需要的動作。它們都佔用製作資源,卻不能一概叫做失敗。試作本來就有價值,問題是下一次生成是否有明確目的。
假設一個鏡頭要拍兩人交接盒子,第一版的問題是手被擋住。繼續送出同樣的安排,期待某一版碰巧拍清楚,和先改掉遮擋再生成,是兩種不同的花錢方式。前者每次都在等模型替我們找到解法;後者至少已經處理了一個知道原因的問題。
所以,估三分鐘動畫的預算,得把試作、修訂和補鏡算進去。只買足三分鐘的生成量,等於假定第一次就能得到所有需要的畫面,而且每一秒都用得上。
Prompt 沒說清楚,預算就可能花在反覆猜測上
如果只要求「兩個人邊走邊交盒子」,模型還得自行決定誰先拿著、在哪裡放手、另一個人怎麼接,以及攝影機從哪裡看。生成後才逐一發現這些安排不合用,就容易陷入一直重抽、一直挑毛病的循環。
我們的夜市段落還有更具體的問題:Kai 的角色圖帶著筆記本和筆,戲裡卻需要他空出雙手拿盒子。提示詞必須排除這些配件,說清楚參考圖只提供哪些外觀。盒子的持有順序、交接後由誰拿著,也要明確。這些條件漏掉,下一次生成就又多了一些可能需要修的地方。
但文字能交代的事有邊界。夜市拋盒子的 previz,曾經讓路人擋住放手的瞬間。我們最後把攝影機從 1.0 公尺提高到 2.4 公尺,才重新安排出看得到手的角度。這個選擇可以在 Blender 裡直接修改、播放,不需要先付費生成完整人物與材質,再檢查視線。
我會先用 previz 解決動作和鏡位,再用 prompt 交代身份、外觀、表演與聲音。 沒有清楚的提示詞,參考素材容易被誤用;沒有可讀的 previz,文字又得替一個尚未排好的場面補洞。previz 篇和有了 previz 之後的提示詞各自展開這兩份工作。
這次沒有做相同條件的成本對照,不能替 previz 報一個省錢百分比。我能確定的是,盒子被遮住這種問題,可以在下一次付費生成之前先看見、先修改。
Higgsfield 的紀錄:同一份提示詞,最多生成十六次
把提示詞寫得仔細,也不會讓每一版都剛好符合作者要求。我們先前分析 Higgsfield《Hell Grind》的公開製作素材,在冷開場收集的 251 支影片裡,只找到 65 份不同的提示詞。同一份文字平均被送出約 3.9 次,最多的一份原樣送出了 16 次。完整語料分析保留了這組比較。
那組十六次生成的畫面,角色的幾個主要外觀特徵持續出現,景別、構圖、光線仍然各不相同。團隊已經寫下許多要求,仍生成了多個候選版本。
這對預算的影響很直接。當要求從「有一個能用的畫面」,提高到「鏡頭距離、表演時機和前後連戲都要對」,能接受的版本就會變少。繼續追求同一場戲的更好版本,意味著更多生成、觀看與修整。若把重抽當成主要解法,高水準動畫的成本自然很難停在這次的 US$196。
《Hell Grind》的影片長度、製作規模與要求都和我們不同,這組次數不能直接拿來替下一支短片報價。它提供的是一個已經發生的例子:即使有詳細 prompt 和資產規則,製作仍可能需要大量候選畫面。預算裡必須替選擇留位置。
對普通人如我們的啟發
對我們這種小團隊,畫面變便宜的好處,是可以提早看到故事長什麼樣子。先試一個 beat,看角色真的動起來,再決定人物關係和下一段要怎麼接。下一次做,我會把工作拆成下面四件事,邊拍邊補。
1. 定義世界觀:角色設定圖、場景地圖
先準備這一場戲會用到的角色圖和地圖。角色長什麼樣子、穿什麼、帶著什麼道具,要有可以反覆使用的參考;人從哪裡進來、門在哪裡、東西要送去哪裡,最好直接畫出來。兩個人隔著一條走廊,和隔著一個轉角,能做的動作就不一樣。
這個世界先做到足以拍下一場戲就好。我們也是先看到幾支原型,才想起 Ocean's Twelve 那種幾個人分工接力的調調,後來再補角色關係和世界。新的畫面讓你改變路線或角色關係,就把決定補回共用設定,下一段沿用;不用等一本世界觀百科全書寫完才開工。世界觀那篇有我們實際用的角色分工和地圖。
2. 畫面設計大於劇本創作:先把一個 beat 拍出來
至少對我們這種還在摸索的小團隊,我會先花力氣設計畫面裡發生的事。每次先寫清楚一個 beat:誰做了什麼、另一個人有什麼反應、結束時事情變成什麼狀態。它可以小到只是丟一張門卡,不必一開始就把整支片的劇本寫完。
像 Biwa 丟門卡這一拍,光寫「她是經驗豐富、喜歡逗弄菜鳥的盜賊」,很難討論她到底多欠揍。讓她真的丟一次,看看 Suseka 的反應,再決定 MeiHua 要怎麼看她、下一段要怎麼接,人物關係就有了能看的東西。動作不好笑,或根本看不懂,再回頭改動作、鏡位或反應。
便宜的畫面,改變了創作順序。 我們可以先做一小段,看到角色怎麼動,再補他們為什麼這樣做。原型裡一個有意思的動作,也可能讓你想出原本沒寫的故事。畫面、人物設定和劇本可以來回修改,文本則把每一輪留下的決定記住,讓下一場戲接得上。
所以不要迴避重抽。試不同的停頓、視線、反應,本來就是在創作。只是這輪要試新的表演,還是修上一輪已經看見的錯誤,自己要知道。每輪留下能用的段落,再決定下一個 beat;總比在一份還沒拍過的長劇本上反覆修辭,更適合我們目前的做法。
3. 提示詞:把官方 skill 裝進本地 Agent
(暫時)不需要了解影片生成模型的原理,但各家模型的提示詞怎麼寫,一定要掌握。官方已經把這些規則整理成 skill,就讓本地的 Claude Code 或 Codex 讀它,帶著你的素材和需求一起工作。
- **MiniMax H3:**官方的
h3-prompt-writing會依純文字、首尾幀或多素材參考選擇對應的提示詞結構,交代畫面、聲音與素材引用。 - **Seedance 2.5:**官方的
sd25-pe會整理故事意圖、素材各自的用途、動作因果與結束狀態。previz 拿來參考走位,角色圖拿來參考外觀,這些都需要說清楚。
依使用的模型選擇安裝。MiniMax 的命令見官方 repo;Seedance 的安裝與用法也整理在這篇拆解。
# MiniMax H3
npx skills add https://github.com/MiniMax-AI/MiniMax-H3 --skill h3-prompt-writing

# Seedance 2.5
npx --yes skills@latest add https://arkdocs-en.tos-ap-southeast-1.volces.com/skills/ --skill sd25-pe --yes
裝好後,把這一場要用的素材交給 Agent,可以這樣說:
請使用這個模型的官方提示詞 skill,依照我附的角色圖、場景圖和 previz,整理這一個 beat 的提示詞。列清楚每份素材負責什麼、動作開始與結束的狀態,以及我指定的表演。保留我的人物關係和事件結果。
讀回提示詞時,檢查角色有沒有對錯、動作順序有沒有被改掉,以及那個你想拍的反應還在不在。這些 skill 幫你整理需求,這場戲要表達什麼,仍然得由你交代。
4. 分工:Previz、提示詞、生成與剪輯,各自處理什麼
到了這裡,分工可以很具體:
| 工作 | 這一步要處理的事 |
|---|---|
| Previz | 用可修改的 previz 排站位、道具交接、鏡位和動作節奏,先看觀眾能不能看懂。 |
| 提示詞 | 說清楚參考素材的用途、人物外觀、要保留或替換的內容,以及表演和聲音。 |
| 影片生成 | 依這些安排產出候選畫面,再看實際表演與畫面是否合用。 |
| 剪輯 | 把能用的段落接起來,決定停留多久、哪個反應值得留,以及還缺什麼畫面。 |
previz 裡角色就碰不到盒子,先修空間;參考圖裡不該出現的配件被帶進來,就檢查提示詞有沒有說清楚素材用途。幾段各自能看的影片接起來卻很拖,先剪一次,再決定要不要補拍。至於看完才發現人物關係不成立,那就回去改故事,四步可以再走一輪。
每產出一批素材,就放進時間線看看。缺一個反應時,下一次生成才知道要補什麼;已經能靠剪輯說清楚的地方,也就不必繼續等一支從頭到尾都完美的原片。最後怎麼選、怎麼剪,是我們自己要做的決定。
喔對了,記得使用老闆的信用卡付錢。
故事沒有好壞,但畫面呈現是有明確的優劣。