人物長得一樣,為什麼還是演不出我們要的感覺?
把角色設定延伸成表情與姿勢參考:以 SUSEKA、RUK 與美華示範如何保留身份,又把表演做得具體。
人物設定圖回答了「她是誰」,卻未必回答「她現在怎麼看這件事」。
SUSEKA 躍入時,驚訝、咬牙、專注、期待都能成立,但它們會拍成不同的角色。她若一臉驚恐,觀眾容易讀成出了意外;她帶著期待,再笑得越來越開,這場跳躍就成了她享受的遊戲。
Heist 的表情準備,正是把這種差別先做成看得見的圖。
先保留一張固定身份的設定圖
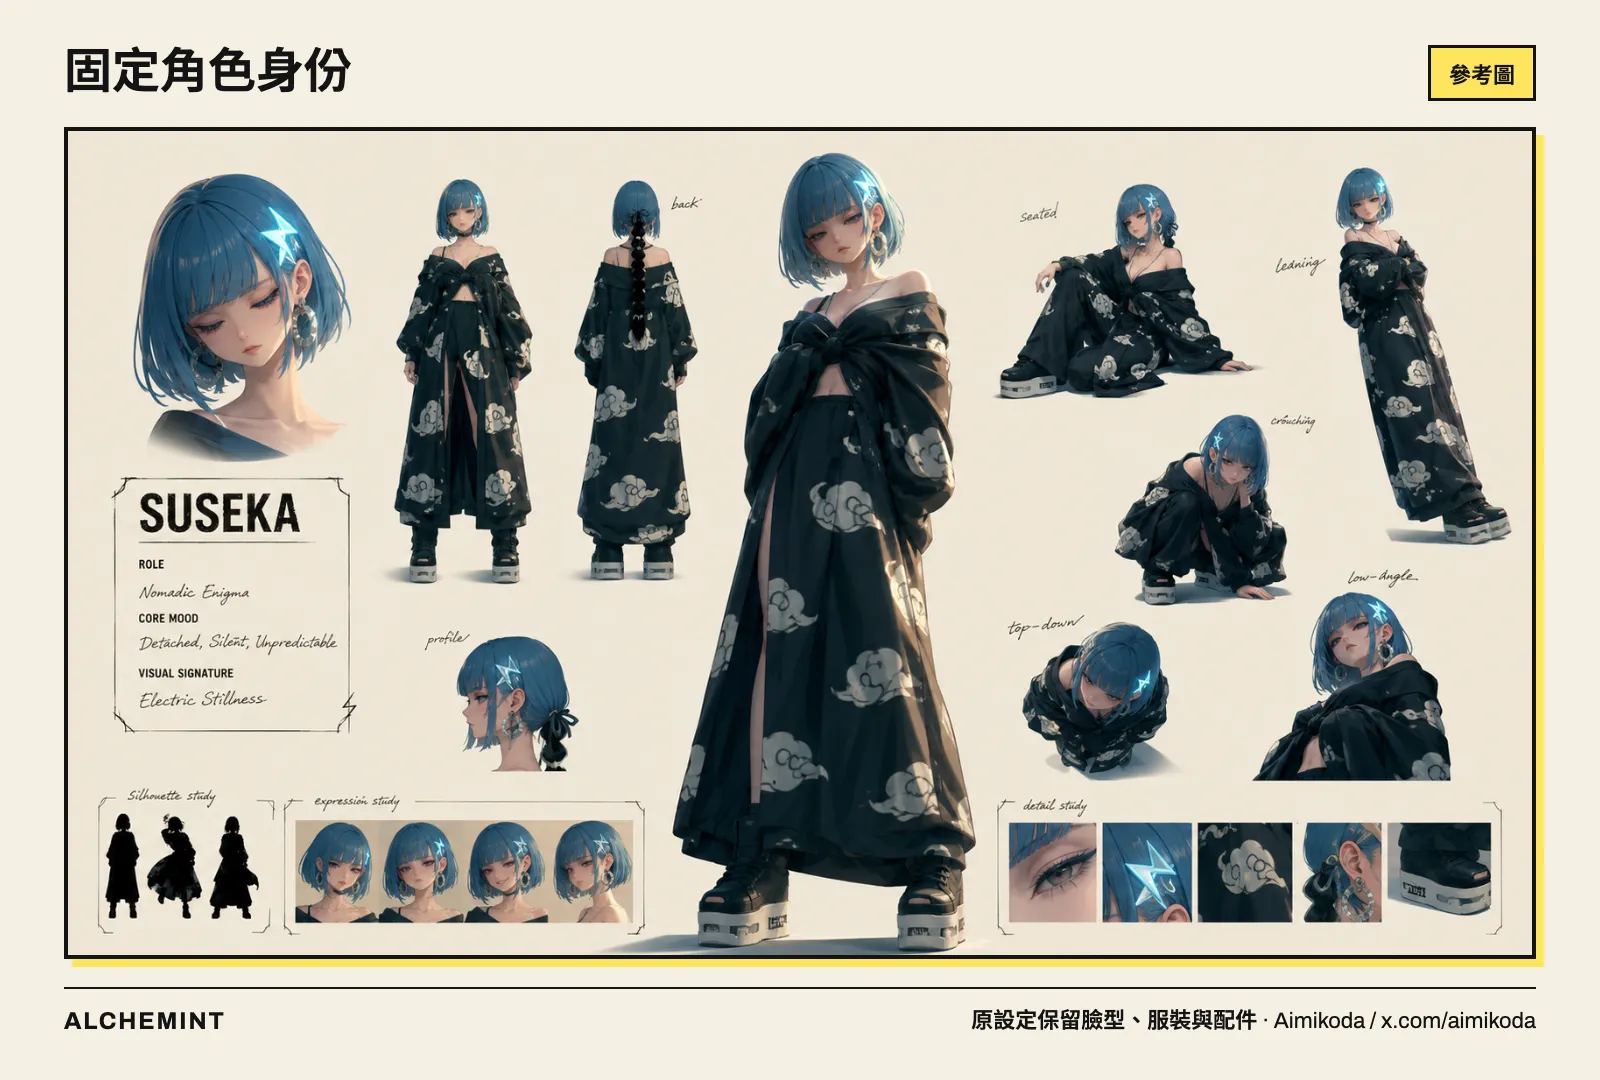
SUSEKA 原人物設定,來源為購自 Aimikoda 的角色素材。後續表情沿用同一身份,沒有重新設計服裝與髮型。
在生成補圖之前,先列出不能跟著表情改掉的特徵:臉型、頭身比例、髮型、髮飾在哪一側、服裝領口與配件。這份清單不用長,但應該能判斷一張新圖還是不是同一個人。
SUSEKA 的星形髮飾在人物自身左側。這裡要寫「人物自身左側」,不要只寫「左邊」:正面圖裡,它位於觀看者的右側;換成背面,畫面關係又會改變。把參照系講清楚,比反覆要求「左右不能錯」更容易檢查。
把情緒拆成一段可演出的變化
先用一句話決定角色對這件事的態度,再選表情。要表現她享受跳躍,可以拆成「期待 → 興奮 → 雀躍」:起初含住笑意,接著睜眼露齒,最後笑得完全放開。每張圖負責一個階段,影片才有變化方向。
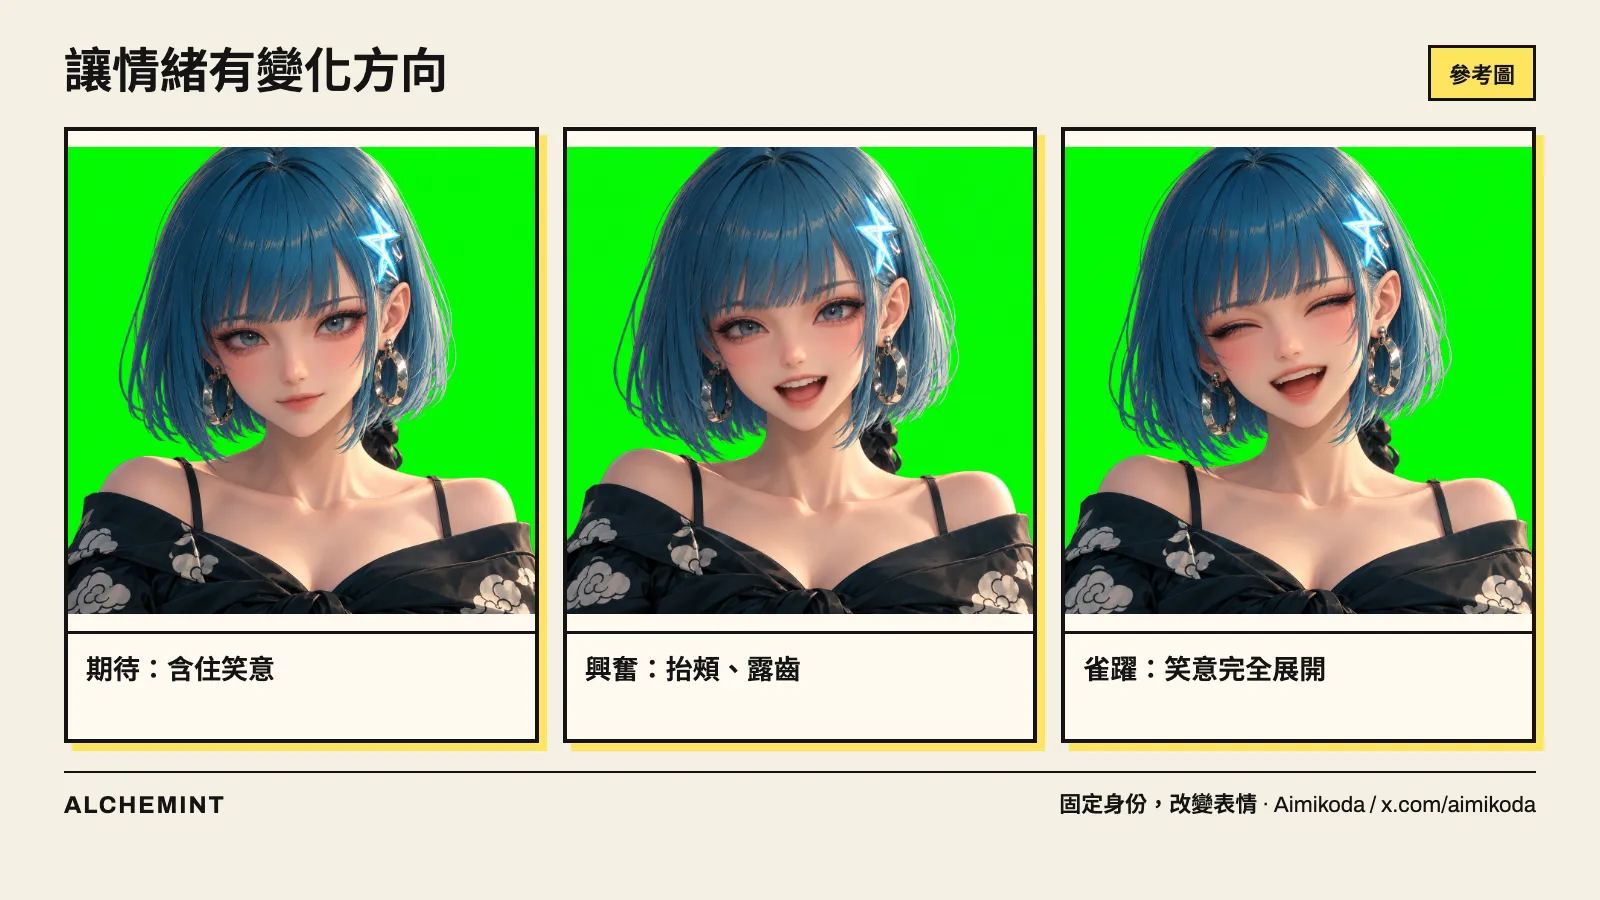
這三張用 GPT 圖像生成。製作同組表情時,同時附上原角色設定和一張已確認的頭肩近景:前者固定身份,後者統一構圖與質感。接著只改表情,讓眉眼和嘴角的差異容易比較。
可以沿用這種寫法。以下是依實際補圖方式整理的中文範例:
圖 1 是人物固定身份的設定圖,保留臉型、髮型、服裝、配件與比例。
圖 2 只提供頭肩近景的構圖、光線與渲染質感。
生成同一角色的一張「期待」表情:目光明亮、眉毛輕抬,
嘴角形成含住的微笑,幾乎閉唇,不露齒;下巴略向前。
情緒是好玩的事即將發生,不是受驚或擔心。
保持單人、單張、乾淨背景,不加入手、道具、字與分格。
如果三張候選只有嘴巴張開程度不同,先回頭看眉、眼、頰與頭部姿勢。情緒名稱只是方向,讀者看得見的是這些部位如何一起變化。
表情強度由這場戲決定
RUK 的驚嚇是另一種尺度。它需要誇張的眼球、下顎與嘴形,才能接住突然醒來、看見 BIWA 的反應。
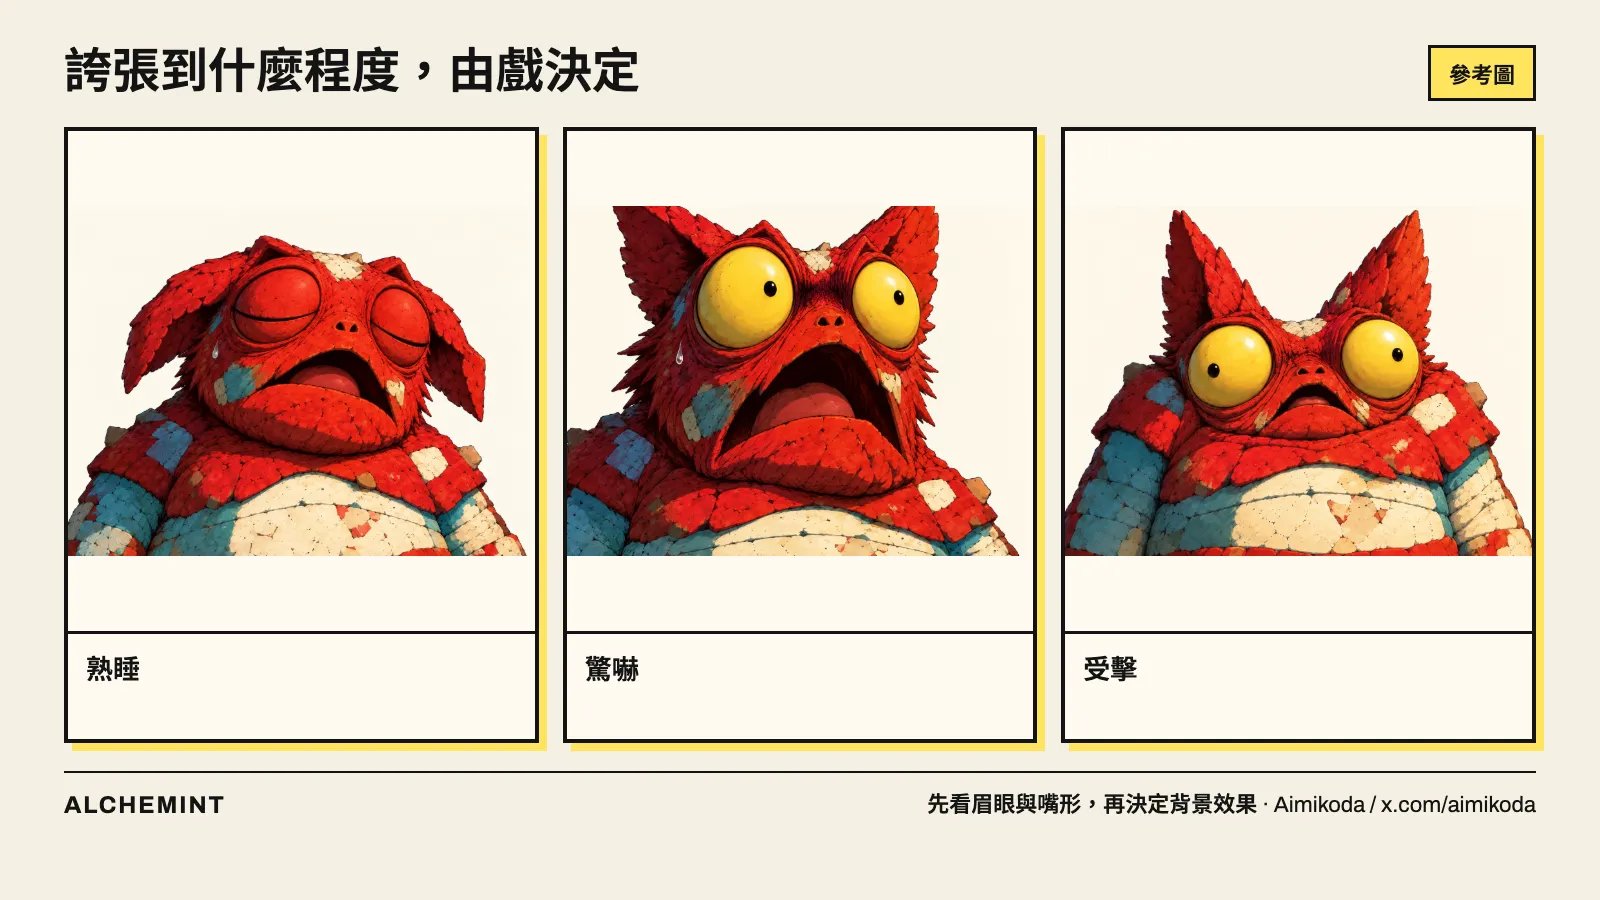
如果只希望影片採用驚嚇表情,就把參考圖外圍的漫畫放射線清掉,保留角色自己的輪廓與陰影。這樣影片模型收到的要求更明確,後續也能另外決定要不要加漫畫效果。
做自己的補圖時,也可以這樣問:我們需要模型學的是這個表情,還是連背景特效也要一起帶進影片?若只是前者,就把補圖的背景清乾淨。
姿勢圖要畫出力從哪裡來
表情之外,美華的臥射需要另一種補圖:右肩抵槍托、右手握把、左手托護木。這些是身體與道具的接觸,只有一張漂亮的人物立繪並不足以說明。
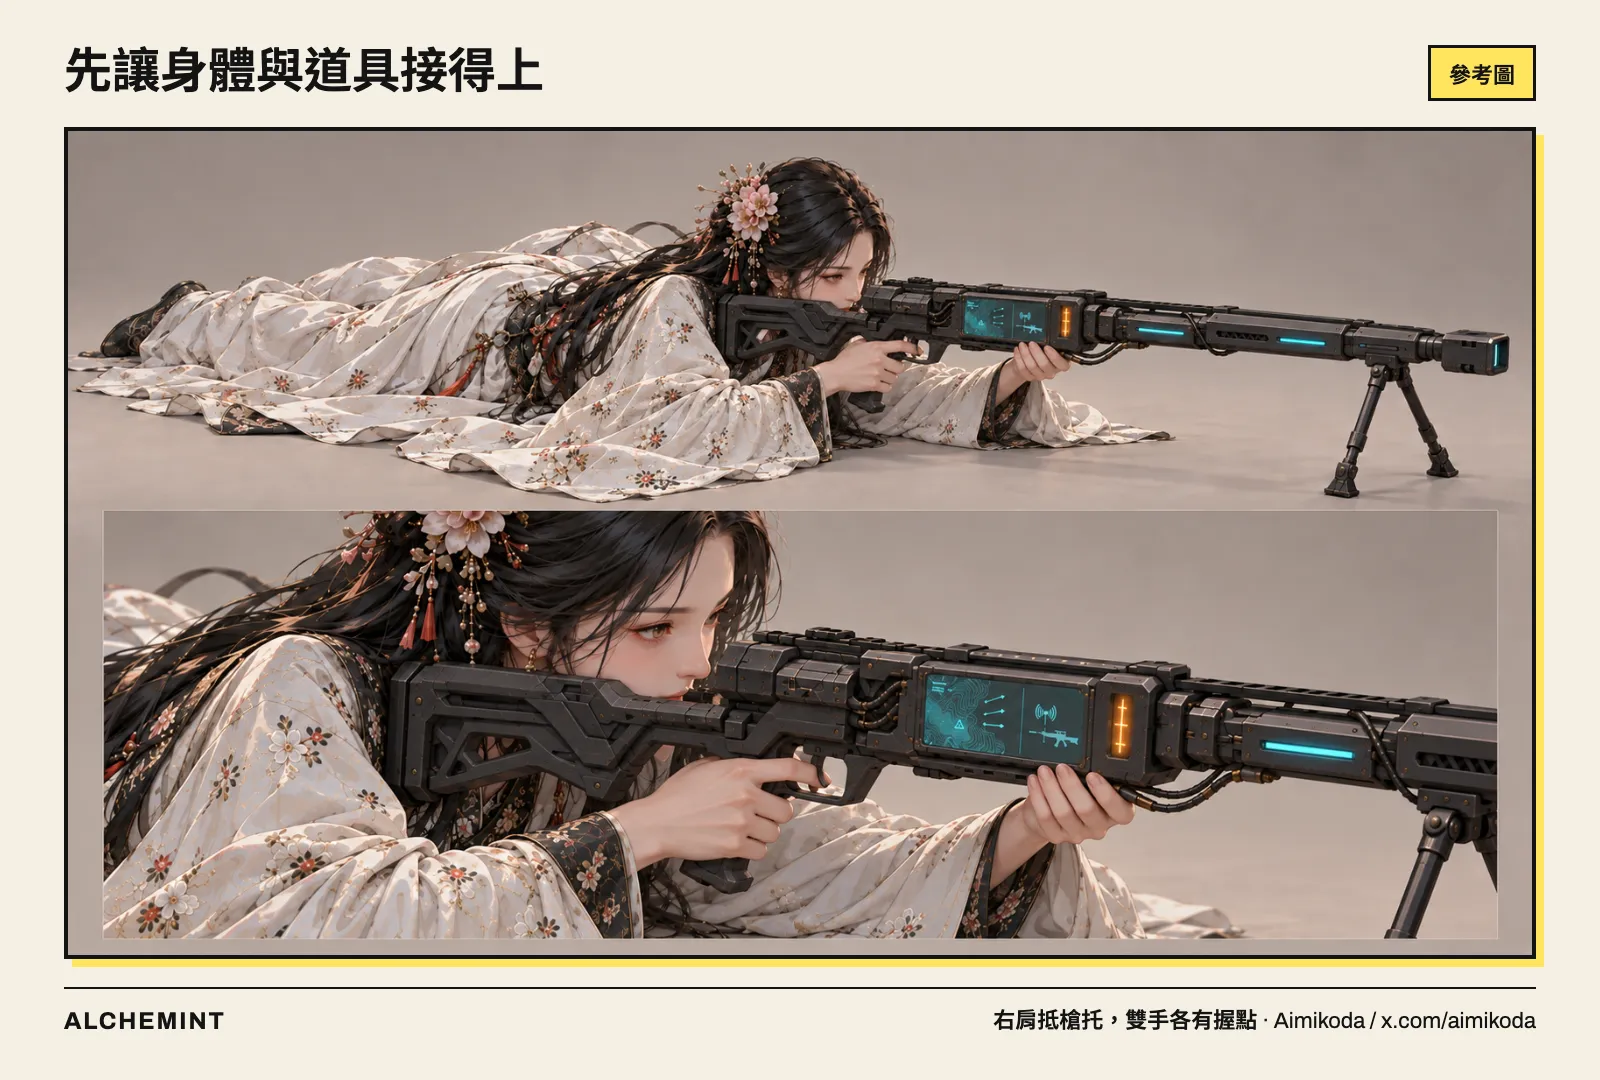
既有的右肩臥射姿勢參考。檢查時要看人物自身左右、槍托與肩、雙手握點;不要只看臉像不像原角色。
可以把要求寫成:「先讓肩托與雙手接觸成立,再維持原角色的衣袖和比例。」如果手掌只是浮在槍旁,這張圖就還沒完成它的工作。把錯誤手位交給影片模型,等於把尚未解決的問題傳到下一步。
送進影片時,說明表情何時有效
在影片提示詞中,把三張圖接成一條表演線:「起跳前含住笑意,靠近鏡頭時露齒笑,躍過鏡頭時開懷大笑。」角色設定固定外貌,表情圖提供各階段的目標,文字則交代它們發生的順序。
SUSEKA 躍入的生成片段。先看笑意如何展開,再分開檢查身體動作與人物位置;表情成立,不代表其他部分也已完成。
同一張表情參考也要有結束的時點。例如 WHITE 前段淡定接話,後段被吐槽後漲紅、跳腳,就應寫明「淡定表情只用於前一句台詞」。若一張「淡定」參考從頭約束到尾,反而會壓住後面的情緒轉折。
補圖做到哪裡,就可以開始生成?
先準備同一人物的設定圖,再補這一鏡缺少的關鍵表情或姿勢。沒有需要變化的情緒,就不必湊齊一整套表情;道具不入鏡,也不用為它補握持圖。
把補圖並排看,身份一致、表演差異清楚、手與道具接觸合理,再在提示詞裡寫明使用時段,就可以開始嘗試影片生成。若還看不出「期待」和「受驚」的差別,先修表情圖;如果困難是相機從哪裡看,則轉去做預演,繼續補更多臉部圖片不會解決它。