用 AI 做影片:先決定從文字、圖片還是腳本開始
文字生成影片和參考素材生成影片不是互斥選項,而所謂的腳本生成影片其實是影視工作流。從手上的素材與不能失控的部分出發,選擇每個鏡頭真正需要的輸入方式。
想做 AI 影片時,可以先分成兩種輸入方式:
- 文字生成影片;
- 參考素材生成影片;
對創作者真正重要的差別是:你準備交給模型多少決定,又有哪些事情必須由自己先固定。
只有一句文字時,模型要替你決定角色、場景、構圖和動作;先準備一張圖片,可以約束外觀或構圖;若把它當首幀,才會進一步限定畫面的起點;交出完整腳本,工具可以協助拆段、配音和組裝,但你仍然要判斷它選的鏡頭是否真的在講你的故事。
所以問題不是「哪一種功能最好」,而是「我手上已經有什麼,這支影片最不能失控的是什麼」。
如果你還沒完整做過一支影片,可以先讀〈第 1 篇:從生成片段到真正能發布〉走完一輪,再回來處理「每一鏡該用哪種輸入」這個更細的問題。
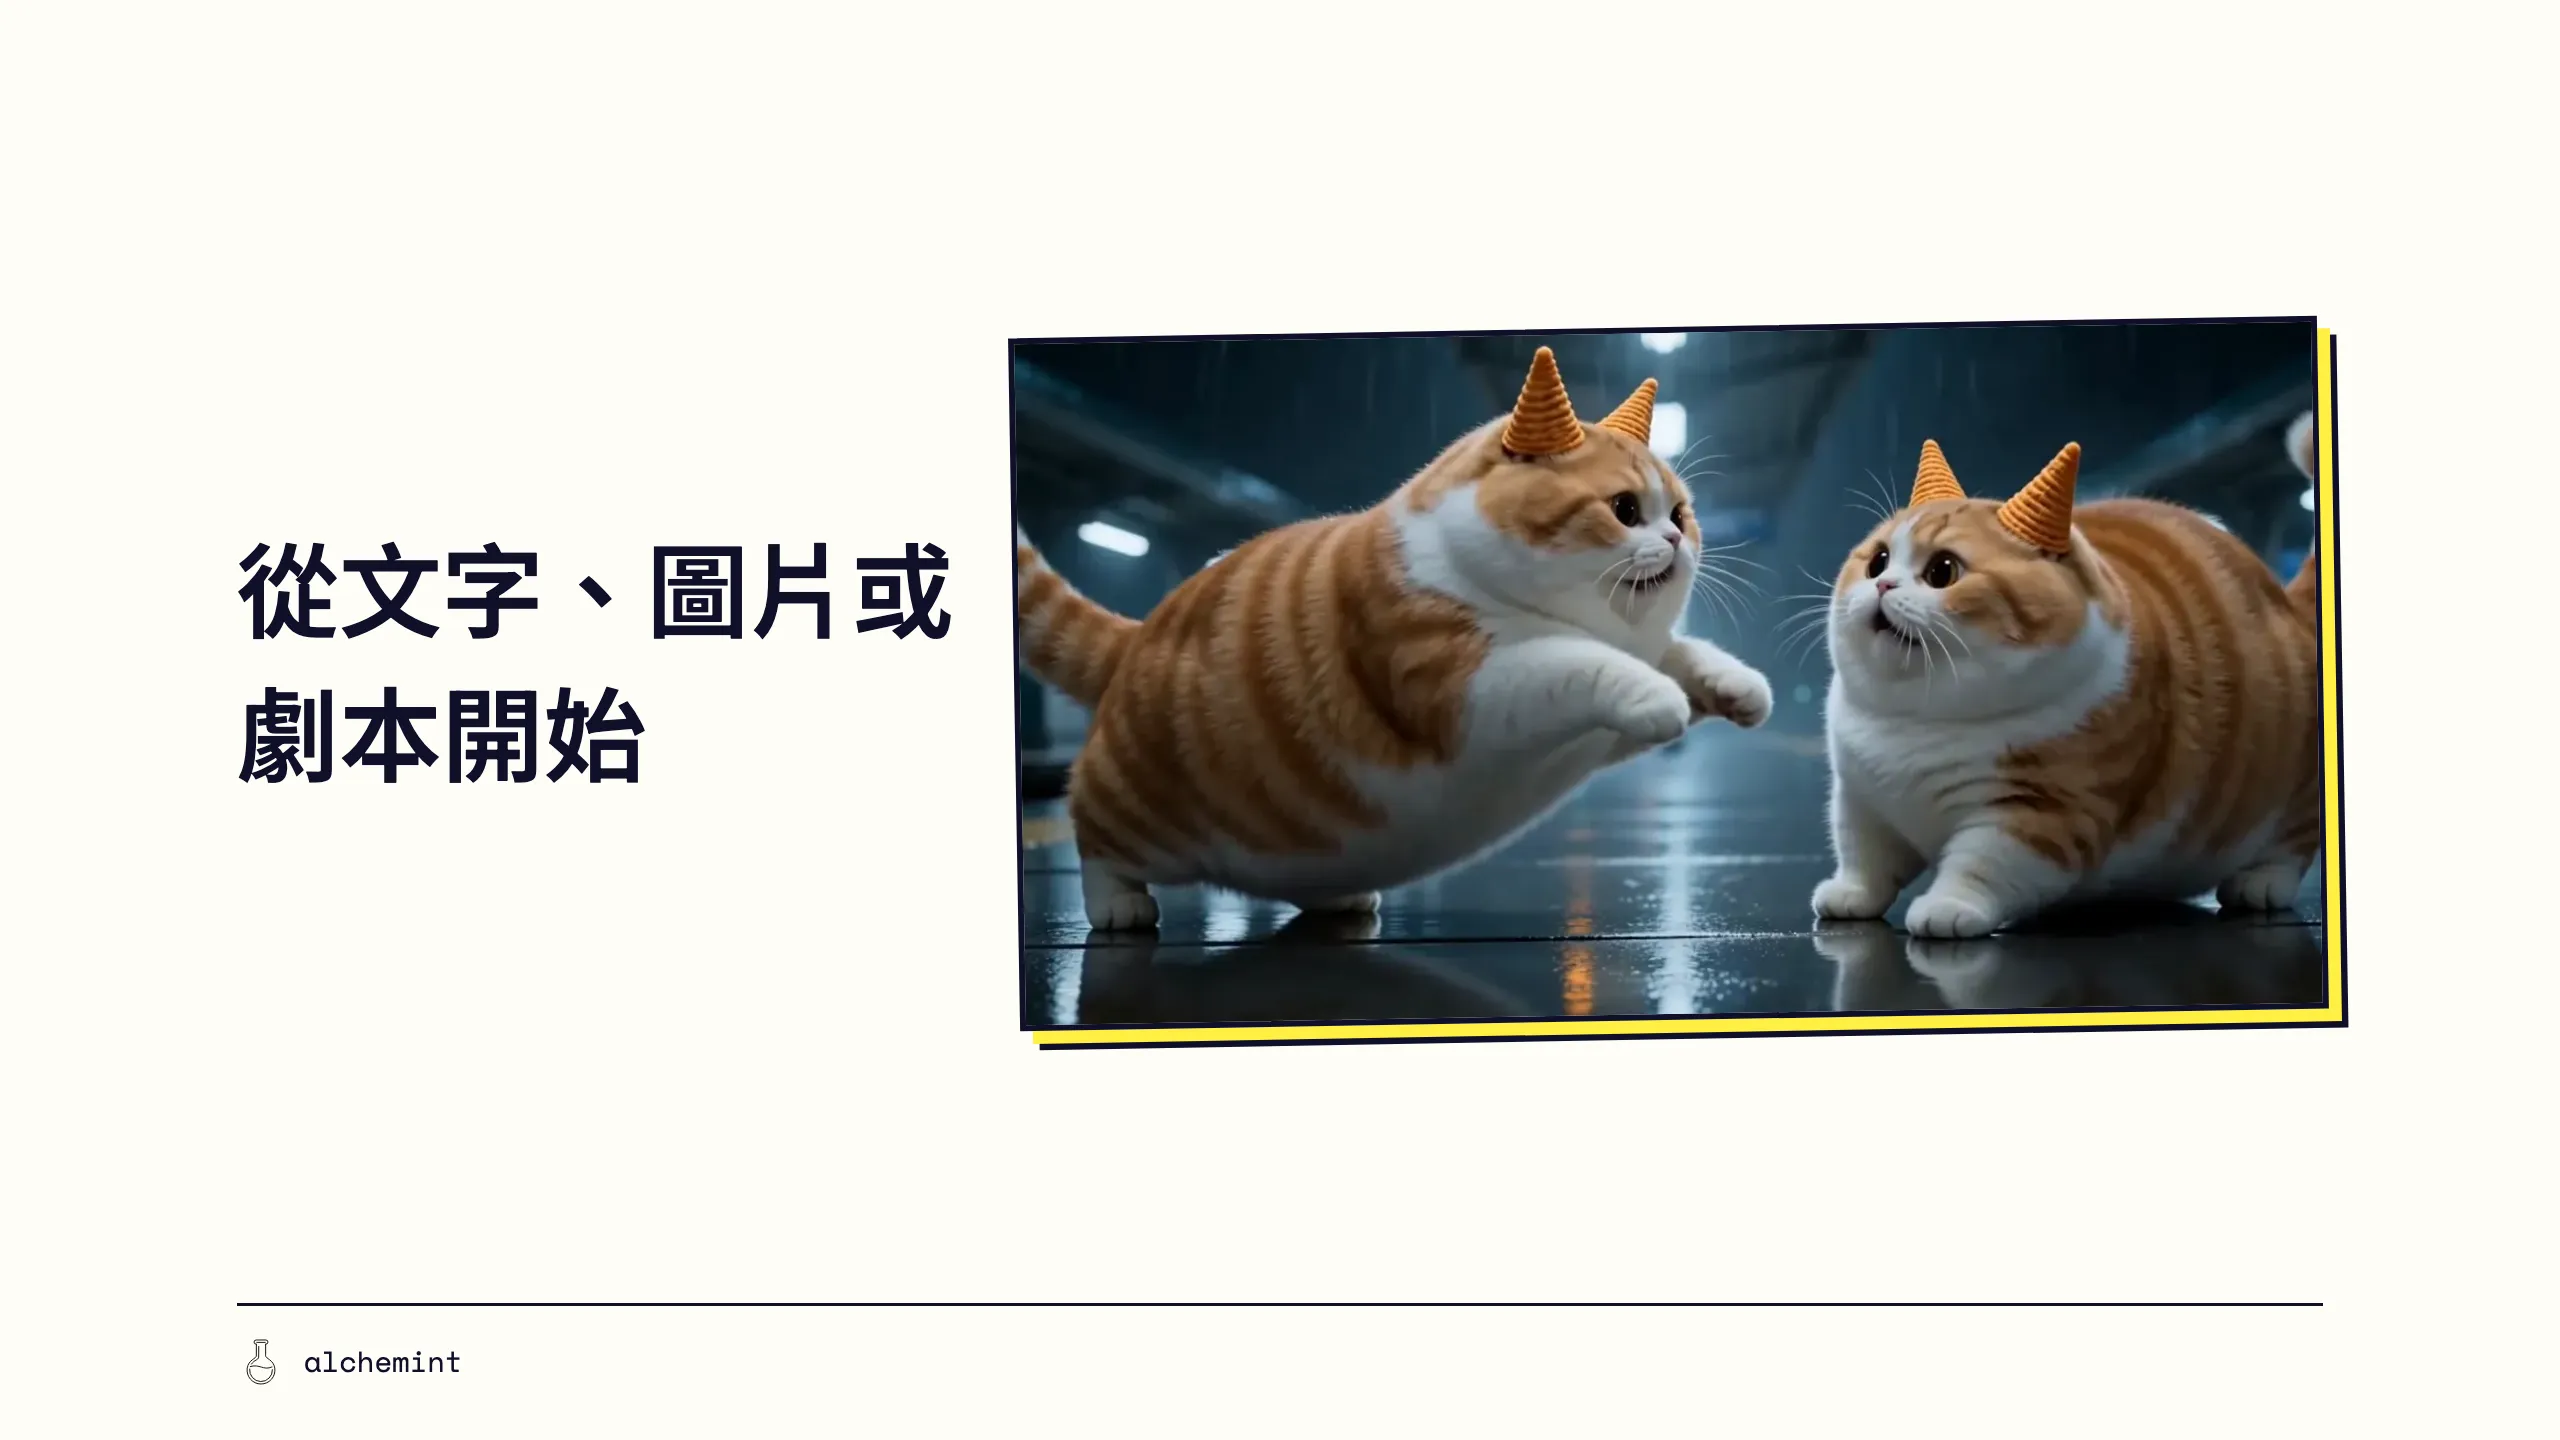
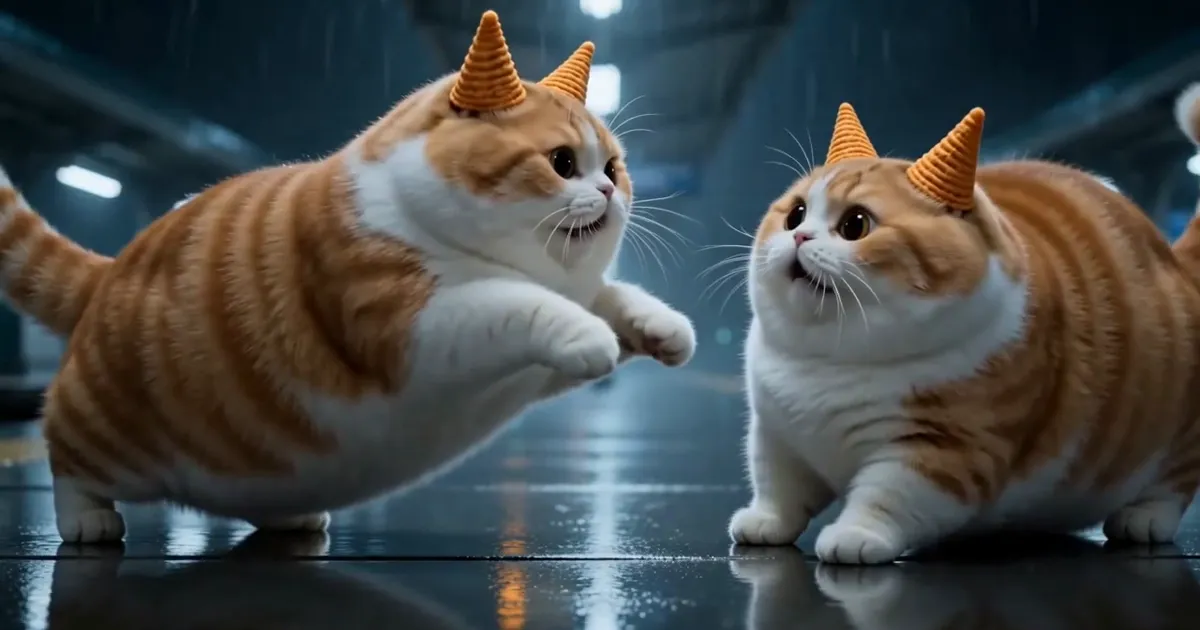
這次讓妙脆角貓去遠一點:火車站。
文字生成影片:模型就是導演,你只是出錢的製片人。
文字生成影片最適合的場景就是純粹好玩 你不差錢。
你可以輸入:
空蕩的雨夜車站,妙脆角貓孤零零的在候車月台兩眼無神的望著月台,鏡頭從月台開始左搖到妙脆角貓,寫實電影感。
但是當你想要多加鏡頭或者切鏡,你就要祈禱模型會用同一個車站、同一隻妙脆角貓。
探索階段,你可能願意接受這些變化:
- 人物外觀每次不同;
- 商品細節被重新設計;
- 重要物件出現在錯的位置;
- 動作、光線和運鏡同時由模型自行決定。
文字生成影片適合用作靈感起爆劑,創意往往是看到畫面才開始誕生。但「這個想法可以長什麼樣」,不一定適合直接回答「我要的那一鏡能不能精準完成」。
我才是導演,我要使用圖片或影片來引導模型
我們選擇妙脆角貓作為系列的主角,是對模型能力的考核。模型能理解也能畫出貓,但是當提示詞寫了妙脆角貓,也寫了耳朵是妙脆角的時候,模型得去推理妙脆角是什麼。與其一直解釋,不如給他圖片。
你也會在社群上看到 AI 生成的武打片段,可是實際上要你真的用文字描述出武打動作,這個比你寫小作文紀念分手還難。
將 img_1 貓耳朵為妙脆角的貓定義為妙脆角貓A。
將 img_1 貓耳朵為妙脆角的貓定義為妙脆角貓B。
空蕩的雨夜車站,img_1 妙脆角貓A與 img_1 妙脆角貓B在空無一人的月台上,對視著彼此,彼此互相試探。以他們為主體,鏡頭環繞。切換到中景,img_1 妙脆角貓A對 img_1 妙脆角貓B揮出一拳。
使用參考圖或者影片,是你要承接角色、鏡頭、動作等更細膩的控制。
你使用的參考素材越好,模型才能更有效的幫助你。所以選圖不能只問「這張漂不漂亮」,還要問:
- 它適不適合接下來的動作?
- 畫面外需要被補出的資訊多不多?
- 角色、物件和背景有沒有互相遮擋?
- 參考素材要解決什麼問題?
這就是為什麼系列文章的第一篇的妙脆角貓圖片是白色,因為我們要讓模型專注在理解那張圖片中的妙脆角貓。
腳本生成影片:這個選項未來可能會釋出
先講結論:腳本生成影片就是影視工業已經跑了一百年的工作流。
在需要事先規劃的拍攝裡,開拍之前會把故事拆成段落、再拆成鏡頭,每一鏡標好景別、運鏡、時長、這一鏡發生什麼、誰說了什麼。這張表叫分鏡表(shot list),第 1 篇你已經做過一張,只是那時沒有展開講它為什麼要長成那樣。
所謂的「腳本生成影片」,做的就是把這張表搬進工作台,讓你逐格把決定填進去。
真正該理解的是接下來這件事——這類工作台可以把欄位整理成提示詞與生成參數,再送進模型;實際做法要看工具。 欄位讓你逐項交代鏡頭,也方便檢查漏了什麼。
所以介面長什麼樣不重要。它可以像劇本編輯器、像時間軸、像一份 Google 試算表,但下游仍需要具體輸入。表單能提醒你先決定景別、運鏡與時長,不能保證每個欄位都填對,也不能代替看片。
至於那段提示詞到底該怎麼組織——哪些字真的有用、哪些字只是安慰劑、模型實際讀進去的是什麼——那是另外一篇的事了。
真正要比的是準備時間、重抽、控制力與剪輯量
「生成比較快」不等於「完成比較快」。下表的圖片生成影片,指以圖片作為首幀的模式;一般角色或風格參考不一定固定起始畫面。
| 比較項目 | 文字生成影片 | 圖片生成影片 |
|---|---|---|
| 前置準備 | 通常較少 | 需要先做或選圖 |
| 模型自由度 | 高 | 中,受起始畫面限制 |
| 角色/商品控制 | 較容易漂移 | 參考圖清楚時較可控 |
| 動作控制 | 主要靠文字 | 受起始姿勢影響 |
| 後續整理 | 可能需要大量選片 | 需要管理多張 reference |
這張表不是排名。你的任務如果是探索視覺,模型自由度高可能是優點;任務如果是商品影片,外觀漂移就可能直接讓鏡頭不能用。
比較的終點應該是「哪條路讓我用最合理的準備和修正,完成這支片」,不是「哪個按鈕最快吐出影片」。
模型也沒那麼不聽話,前提是你判斷得出哪裡出問題
一支影片不需要忠於單一輸入方式。
雨夜車站可以這樣做:
- 用文字生成影片或文字生成圖片,探索車站氣氛與畫面方向;
- 選出主角、服裝和場景,整理成角色與場景 reference;
- 依 storyboard 做每個鏡頭的起始圖,再用圖片生成影片完成動作;
- 把腳本當成整體敘事和字幕/旁白依據,而不是要求工具一次生成全片;
- 最後在剪輯時間軸裡重新決定鏡頭長度、聲音和順序。
這種混合做法看起來多了步驟,但每一步只處理一種問題。當角色不對,你回去檢查角色圖;動作不對,修改該鏡提示詞;故事節奏不對,回到腳本和剪輯,而不是把全部素材重做。
- 01用 AI 做影片:提示詞就是你的影片
- 02用 AI 做影片:先決定從文字、圖片還是腳本開始你在這裡
- 03用 AI 做影片:讓每個鏡頭接得上的簡單 Storyboard
- 04AI 影片角色一致性:從 Biwa、Suseka、MeiHua 的人物設定圖開始