教學
產品教學・行業觀察・創作活動・更新公告
顯示 7 篇文章
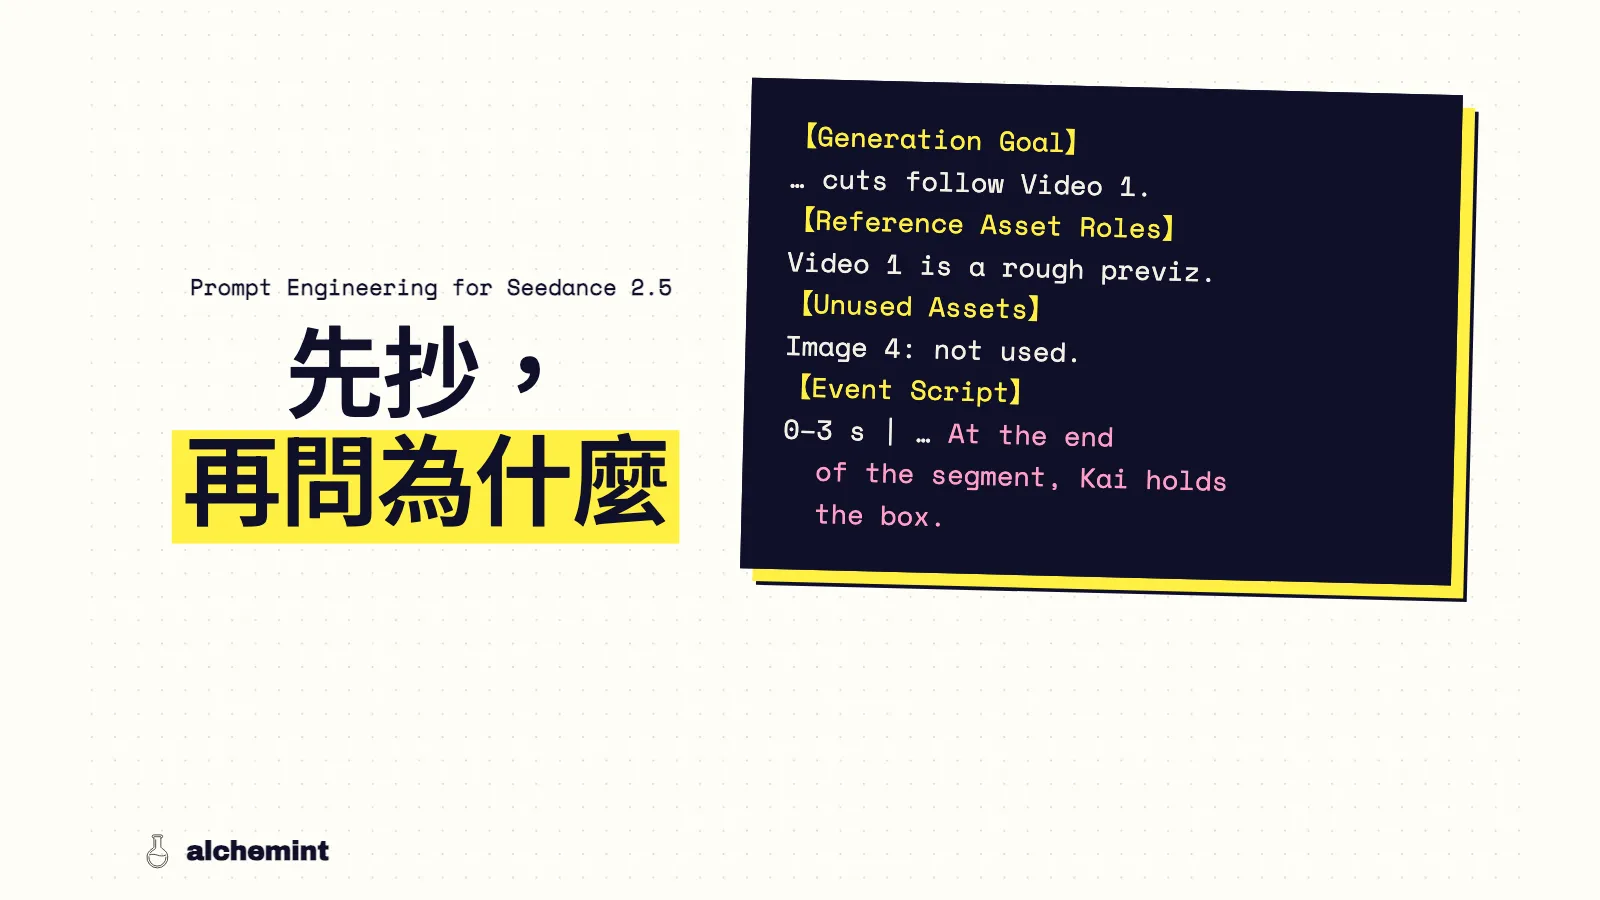
Prompt Engineering for Seedance 2.5:previz 轉片提示詞模板
一份可以直接填的 Seedance 2.5 previz 轉片模板;後面說明為什麼這樣寫:previz 負責切點與時機,提示詞負責對應和狀態。
閱讀全文 →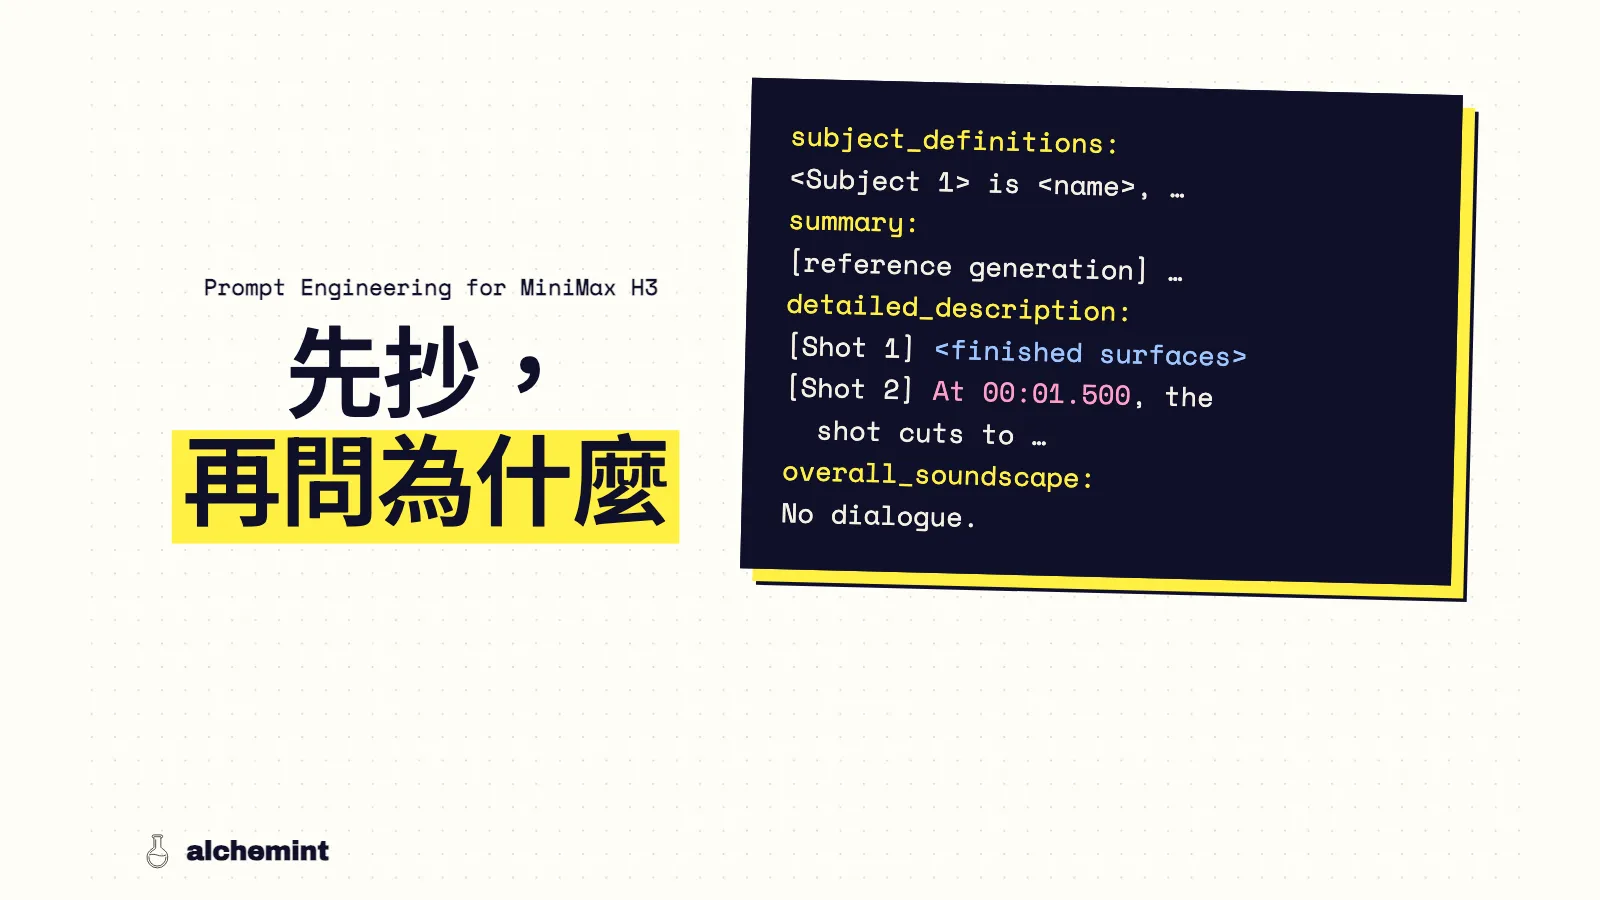
Prompt Engineering for MiniMax H3:從 246 支成片反推的 previz 轉片模板
一份可以直接填的 MiniMax H3 參考影片模式模板,用在 Blender previz 轉片;後面是模板背後的五條規則,每條都來自 246 支成片的實測。 先給模板。這份模板用在 MiniMax H3 的參考影片模式,以 Blender previz 當 <Video 1>,格式照 MiniMax 官方的六節。裡面每個寫法都來自 246 支成片的比較:41 個 previz 單元各寫兩版,一版由 MiniMax 付費提示詞優化器產出(V1),一版由 agent 依官方提示詞 skill 撰寫(V2),都跑在三個開源 H3 版本上。為什麼這樣寫,放在模板後面。 模板 正文用英文,這是官方格式的要求。尖括號是要填的地方。這份模板是依下面五條規則組出來的,沒有另外單獨跑過測試。 subject_definitions: <Subject 1> is <名字>, <3–6 個辨識特徵:髮型、服裝主色、招牌配件> in <Picture 1>. <Subject 2> is <道具>, <造型、材質、可見標記> in <Picture 2>. <Subject 3> is <地點>, <牆面與地面材質、光源、時段> in <Picture 3>. <Video 1> is the <N>-second previz: camera, blocking, action order and contact timing. <Subject 1>'s proxy in <Video 1> is <顏色>. (每個角色一行,需要時才寫) summary: [reference generation] <一句話:誰做了什麼、結束在哪、最後誰拿著什麼> retention_analysis: <Subject 1> (appears in [Shot 1], [Shot 2]): fully_preserved - identity, outfit and accessories. <Subject 2> (appears in [Shot 1], [Shot 2]): fully_preserved - shape and materials. <Video 1> (camera and blocking): fully_preserved - positions, motion and timing. Start: <起始狀態>. End: <結束狀態>. detailed_description: The target video is in <一句風格>. [Shot 1] <景別與機位>. <這一格看得到的完成表面:材質、光線、時段>. <Subject 1>, <這個景別看得到的特徵>, <在畫面中的位置>, <動作>. At the end of this shot, <誰拿著什麼、在哪>. [Shot 2] At <previz 切點 MM:SS.mmm>, the shot cuts to <景別與機位>. <同樣寫法>. <切鏡後立刻開始的動作>. overall_soundscape: <環境聲與動作聲;沒有台詞就寫 "No dialogue."> non_diegetic_music: N/A 送出前的檢查: previz 的每個切點都寫成 At 時間,而且和 previz 對得上。 每一鏡都以完成的表面開頭,gray、proxy、blockout 這幾個字最多出現一次。 沒有任何一鏡要求它的景別拍不到的東西。 不想要的東西已經從參考圖裁掉,而不是寫在排除句裡。 攝影機看得到的每個物件,都有參考圖或材質描述。 模板為什麼這樣寫 官方格式告訴你東西放在哪裡,卻沒告訴你哪些句子會改變畫面。下面五條規則,來自 V1 和 V2 拍出不同畫面的地方。 規則 1:每個切點都寫成時間 H3 從文字拿切點時間。最清楚的例子是一支在 1.5 秒切鏡的 previz:優化器的提示詞寫 1.1 秒,三個版本都在 1.08–1.21 秒切;官方 skill 寫的提示詞寫 1.75 秒,三個版本都在 1.71–1.75 秒切。同一支影片、兩份文字、兩個切點,沒有一支切在影片的 1.5 秒。 整批來看,以 ±0.25 秒為準,文字有寫的 previz 切點有 43–56% 的成片照切,沒寫的是 6–19%。有五個切點只寫在 V2 裡:V1 的 13 支成片一次都沒在那裡切,V2 切了 4 次。兩版之間其他句子和 seed 也不同,這組數字看方向,不當成比例。 切點時間要從算圖出來的 previz 抄,只看攝影機資料不夠:那個單元的攝影機資料寫 1.75 秒,算圖卻在 1.5 秒切。如果用付費優化器改寫,要拿它的時間和你的清單逐一比對:對照 previz 的攝影機資料,它漏寫了 53 個切點中的 10 個,改了 5 個。完整比較在切點篇。 規則 2:描述完成的表面,不描述 previz 這條是我最難證明、卻最有把握的。V2 提到 gray、proxy、blockout 這類字的次數是 V1 的 2.3 倍(每份提示詞中位數 9 次對 4 次),否定句(not、no、do not)是 5.5 倍。V2 留在畫面上的 previz 也多很多:在快的 QuantFunc 版上,39 個單元裡 13 個留下 previz,V1 只有 3 個。兩版之間改了很多句子,沒辦法把效果歸到單一句。但 V2 一直在描述它不想要的東西,結果就得到了。 所以每一鏡開頭都先寫攝影機看到的完成世界:材質、光源、時段,例如「暖色燈籠光下的濕石板路」。previz 的對應每個角色留一行就好,不用解釋 previz 只是佔位。 沒有參考圖的物件也一樣。一盞做成紅色球體的警示燈,每個版本都畫回一顆上了色的紅球,因為提示詞沒說那是什麼樣的燈。攝影機看得到的東西,都要有參考圖,或一句描述它真實材質的話。細節在previz 殘留篇。 規則 3:每一鏡只寫畫面裝得下的東西 角色定義描述的是整個人,一個鏡頭只拍到一部分。有個單元以一隻眼睛的極特寫開場。V1 先要求這隻眼睛,接著又要求 Kai 站在閘門旁、抱著盒子、部分入鏡。三個版本都把畫面放寬,好把她的臉、盒子和 Kai 都塞進去。 V2 這樣寫同一刻:「The tight image contains the relevant eyelid, iris and nearby facial detail from her reference identity」,接著「While she is framed, <Subject 2> is outside the close-up, still holding <Subject 4> at his side.」三個版本都拍成單眼。 訣竅是把「仍然成立的事」(他在鏡外抱著盒子)和「這一格拍到的東西」(一隻眼睛)分開寫。兩版之間還有好幾句也改了,其中兩個版本切鏡後的畫面留下了 previz。構圖的修正在三個版本上都成立,我現在寫特寫都照這個方式。 規則 4:裁掉參考圖,不寫排除句 有個角色的設定圖裡她抱著一顆足球。她出場的每一份 V2 提示詞都寫了「the football on the sheet is not part of this action」。在一場閘門戲裡,三支 V2 成片有兩支在她腳邊出現了足球;同一場戲的 V1 從頭到尾沒提足球,三支都沒有。我另外檢查了她的三場戲,沒看到足球,所以這只算一個警示案例,不是比例。 另一個案例方向相同。另一個角色的設定圖有白底、名字標題和小姿勢圖。V2 要模型忽略白底、標籤和其他姿勢,仍有一支 V2 成片把整張設定圖的版面貼進了廣場。 設定圖上有不能出現的東西,就從圖上拿掉。裁一張乾淨的單人圖只要一分鐘;寫排除句等於在提示詞裡點名你不想要的東西。 規則 5:寫出每次切鏡之後發生什麼 有段笑點需要三次跳接:同一個角色、固定背景,每次換一個位置,每跳一次都再按一次按鈕。V1 寫了三個位置,三支成片都沒跳出來。V2 補上每次跳接之後的動作:「After the jump, show him lean forward, extend his free hand, and actually touch the button.」三支裡有兩支跳出了三次乾淨的換位。 切鏡要看得懂,切鏡後的那一格就得開始一個新動作。把那個動作告訴 H3。 H3 請求本身的結構(role、參考模式、參數),從 MiniMax H3 提示詞入門開始。 限制 H3 開源工作流一次生成 4–15 秒,長段落要拆成多個單元,每個單元都要重寫自己的起始狀態。有些效果不管怎麼寫都在每種條件下失敗:定格、dolly zoom、變速。那些應該在剪輯裡做,見提示詞與量化篇。V1 和 V2 同時差了很多地方,每支成片又各用隨機 seed,所以上面的規則建立在跨單元一致的規律上,不是單句實驗。 完整的實驗設定見系列開場。
閱讀全文 →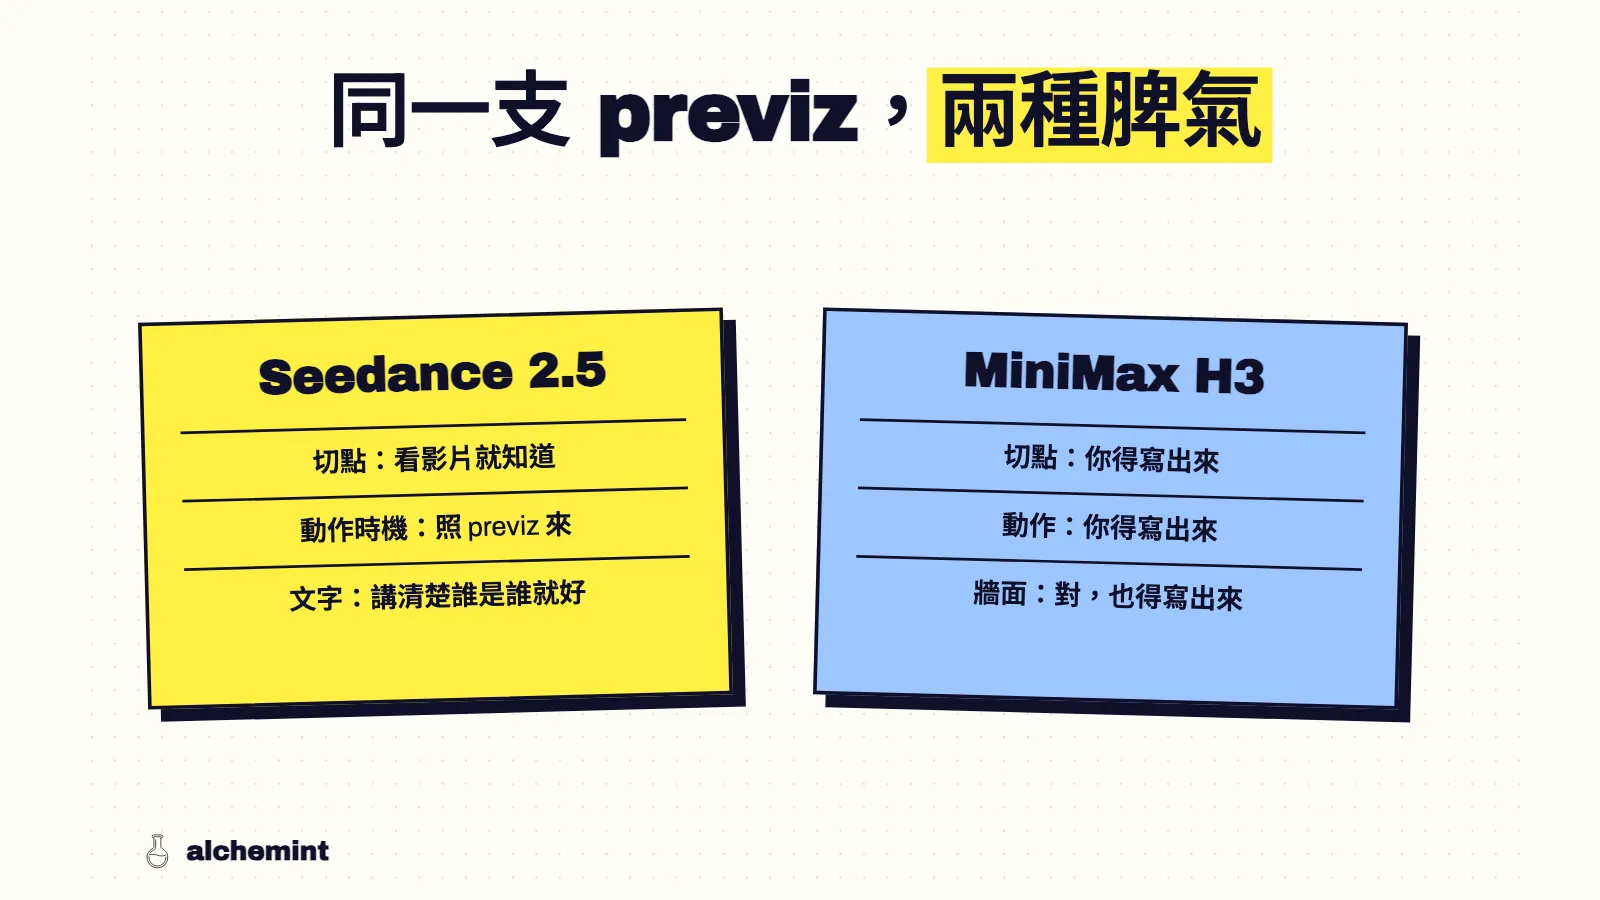
同一支 previz,怎麼在 MiniMax H3 和 Seedance 2.5 之間移植提示詞
H3 和 Seedance 2.5 從 previz 拿的東西不同,所以提示詞不能逐句翻譯。從 32 場兩邊都寫過的戲,整理出哪些資訊該搬到哪裡。
閱讀全文 →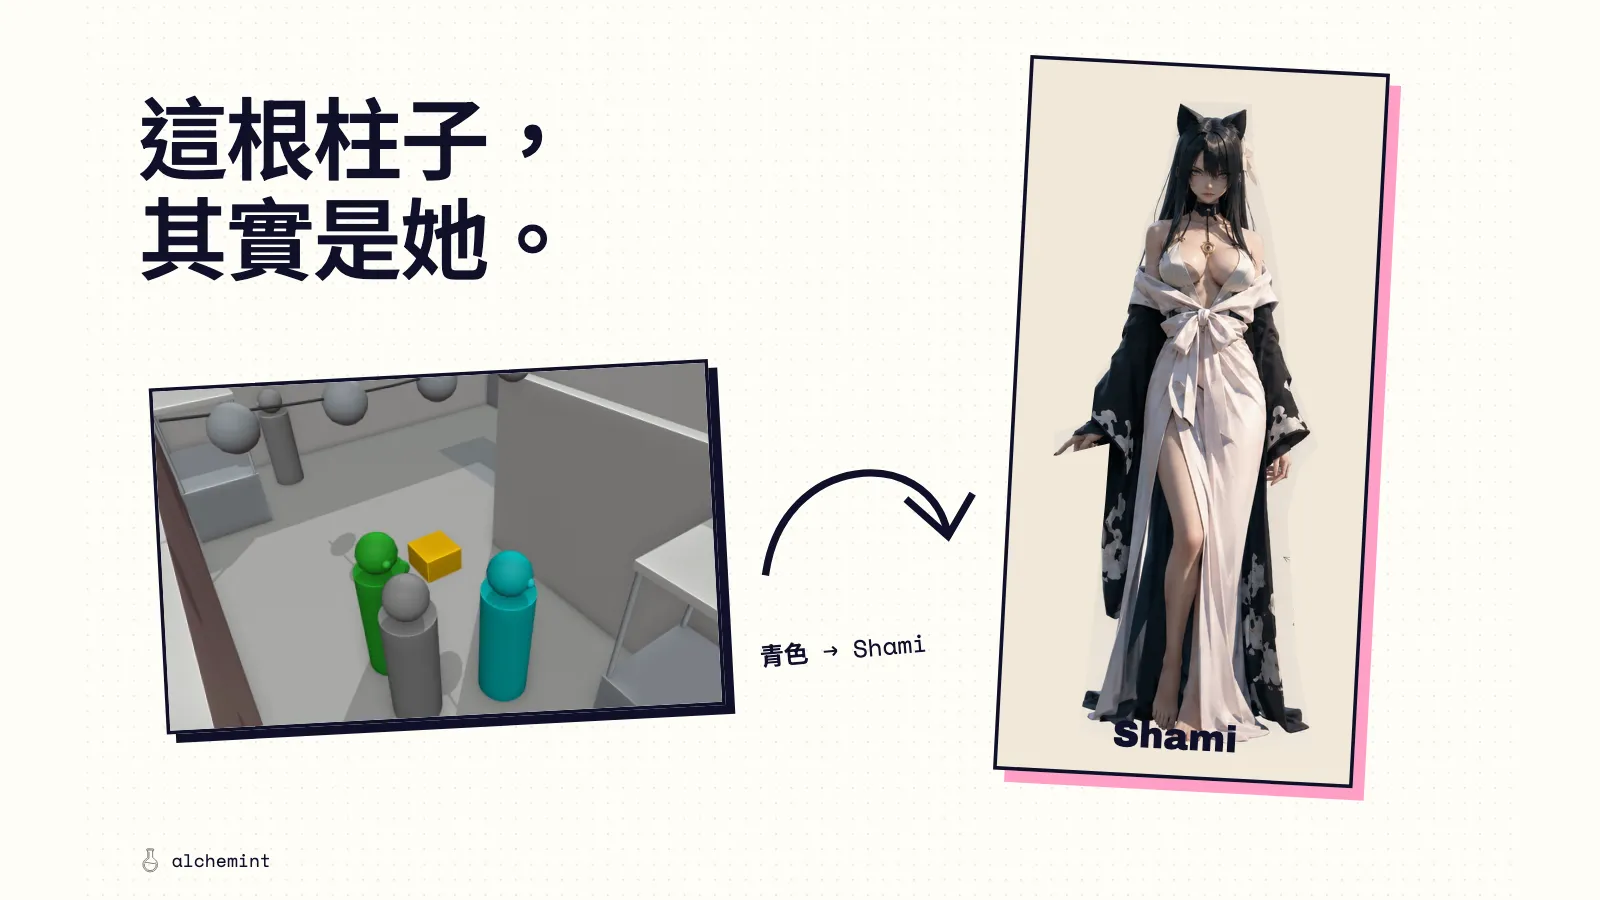
有了 previz,影片提示詞還要寫什麼?
用 Seedance 2.5 官方 sd25-pe skill 整理 previz、角色圖與場景參考。先指定素材分工,再補身份、外觀、表演與聲音,附可改用的夜市交盒範例。
閱讀全文 →分鏡腳本怎麼寫?把一場戲拆成鏡頭,AI 從哪一步接手
分鏡腳本的重點是決定,畫只是載體。這篇從一段三行的腳本開始,示範怎麼標拍點、一拍一鏡定景別與運鏡、寫每鏡的起訖狀態,附一張可以直接抄走的分鏡表格式,並說清楚 AI 能接手哪一步、接不了哪一步。
閱讀全文 →
AI 影片延長後接起來會卡?不是幀重複,是動作斷了半秒
貓與紙船的直式影片用前一段尾幀續生下一段,直接 concat 卻會「卡一下」。我們把 02→03 接縫逐幀量了一遍:沒有一幀重複,是動作停了半秒。幀率怎麼驗、接縫怎麼分、切點怎麼定、54 幀是怎麼砍錯的,全部攤開。
閱讀全文 →
Seedance 2.5 Prompt Skill 到底管什麼?參考圖、故事板與首幀一次拆開
我們拆開 ByteDance 的 sd25-pe v0.1.1,看它怎麼整理故事意圖、素材角色、多宮格故事板、首幀、秒數與生成參數。規則很細,魔法沒有。
閱讀全文 →