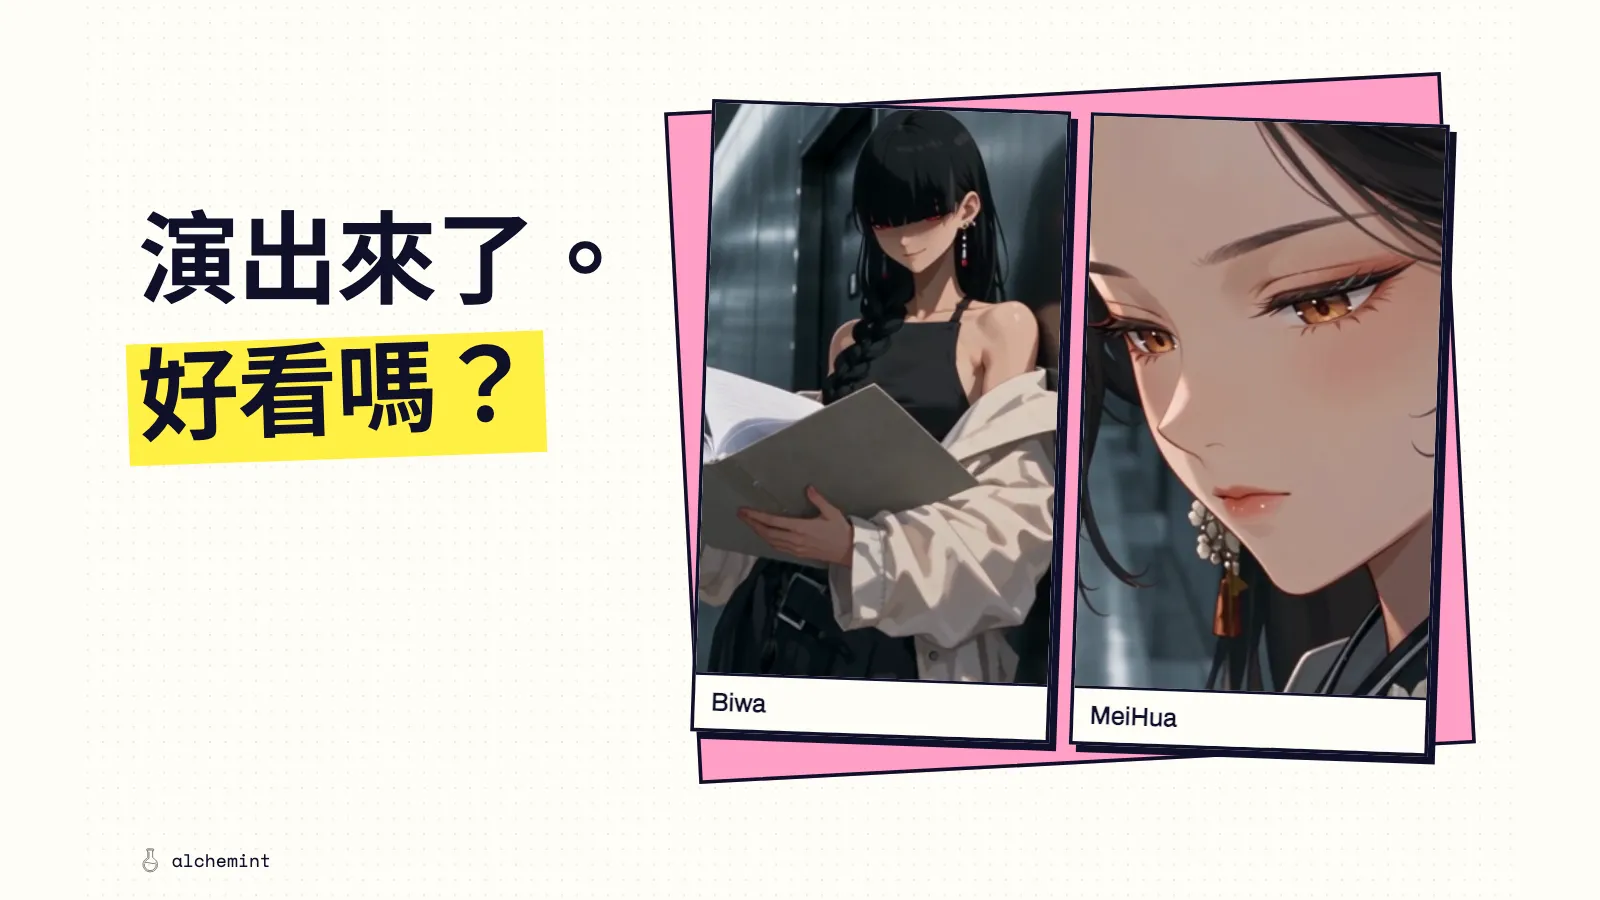
現在用 AI 拍片這麼便宜,我們是不是該學點電影了?
AI 讓小團隊有想法就能試拍。Biwa 要偷笑、兩個人要隔著分割畫面互看,都能拿到實際畫面來討論。然後麻煩就來了:模型做到了,我們卻得開始判斷這場戲到底好不好看。
用 AI 拍片,創作者仍要決定自己想說什麼,以及希望觀眾從一場戲裡感受到什麼。AI 可以協助寫劇本、安排動作、生成畫面;我得判斷這些提案是否在說我想說的故事。
坦白說,我們在準備這隻動畫的過程中,人類介入的時間不到一個小時,角色定位甚至是後來臨時補的。乃至於在劇本上我們團隊只有臨時說了句:「就 Ocen's Twelve 那個調調。」我們沒有要展示什麼很屌的武打片( 多數 AI 生成的武打片看著就是一群沒有武術學習經驗的創作者設計的 ),我們想知道, AI 工具到底節約了什麼樣的成本?有了 Seedance 2.5、Minimax H3、Wan 3等等影片生成模型之後,普通人到底能躍遷到什麼程度?
劇本:我們省略了,直接設計每個 shot 的動作,例如 Episode 1 中 Biwa 丟門卡給 Suseka 那樣婊里婊氣的行為是為了建立 Biwa 的角色設定。
世界觀:這個是我們花最多時間的地方,Episode 1 & 2生成了多個版本之後,我們才叫 Codex 趕緊設計地圖,不然 Seedance 2.5 的自由發揮就會變這樣:
早期生成版本,原片 10–13 秒。
你有看過什麼物理力學可以從讓 Biwa 這個方向拋到 Suseka 腳邊嗎?
早期生成版本,原片 0–3 秒。
kai miren 消失在門前???這要人類畫師來畫都畫不出這麼精美的特效。
音效:直接省略,suno 的音效提示詞我們半年前在那邊抽卡抽到信用卡爆了。 配音:奪寶哪那麼多台詞?其實也是我們直接省略了。
影片生成模型是能遵照用戶的意志(提示詞)來實現,從藝術層面而言,畫面並不需要被牛頓的蘋果所束縛。但問題是,會寫提示詞再搭配開源模型,是不是就可以去報名奧斯卡了?
AI 工具已經能降低 filmmaking 的門檻,但創作裡最根本的工作仍然存在。我們想透過實際做完一支影片,把工具替我們做掉的工作,以及最後仍然要自己決定的事,分開看清楚。
好萊塢的編劇為什麼要罷工?
我們最早建立的影片工作流就是跳過了創作創作,這還真不是看一般人沒有,而是雕琢劇本在這種創作過程中是不符合成本效益的。但是,每個 beat 要發生什麼事情是不可跳過的。觀眾可以不看劇本就能看懂電影,與其寫一段劇本來描述 Biwa 為什麼總是婊里婊氣,不如就乾脆讓她丟卡片。但她不是真的婊里婊氣,所以還是讓她撿起卡片,並且交給 Meihua 。
在我們團隊所定義的角色關係中,Meihua 是 Ep 1 三人組的老大,承擔智囊的角色、Biwa 是關鍵輸出(偷來的卡片),經驗豐富,臨危不亂、Suseka 是剛出道的菜鳥,是 Serelya 的妹妹。
但是,視頻生成模型壓根不在乎你的人設,我們也建議用戶不要浪費時間在提示詞描述人物關係,動作的描述就是你的提示詞、用清楚的動作、描述動作因果關係,這些才是提示詞要看的。(我們在〈Seedance 2.5 Prompt Skill 到底管什麼?〉裡,也拆過怎麼把抽象意圖整理成可拍的動作。)
後來我們通過了 Previz 給 Seedance 2.5 做鏡頭、機位的指引之後,AI agent ( codex astra max )專注在提示詞的撰寫,後續我們抽卡的頻率直線下降,Ep3 - 8,基本是一次過。
這讓我們不禁想起早些年好萊塢編劇罷工事件,在未來的影視劇工業,當一段畫面的製作成本低到接近 X 軸的時候,編劇這個角色是不是會再度面臨價值鏈上分配不均的狀況?在我們製作的過程,團隊花最多時間是定義畫面,而不是在影片在文本上的樣貌。
若你是小團隊,腳本、人設、試拍在適當的提示詞撰寫後,只需要大概5分鐘吧,Seedance (你要用開源模型例如 Wan 2.2 也可以,成本更低,只要你買得到 5090 還可以更快)就可以提供一段畫面作為評估。
未來的影視劇工業,大的我們不敢說。但對小團隊而已,基於提示詞的互動式創作是影片類型內容製作的最小執行單位。
影片生成模型的下限是用戶想像力的上限
「就 Ocean's Twelve 那個調調」可以幫我們找一種氛圍,讓幾個人分工、接力,把一件事做成。但拍到這張門卡時,還是得回來決定:我們希望觀眾怎麼看 Biwa?
Ep 1 shot 1 在 16 - 19秒的提示詞:「MeiHua 先看向走廊靠牆的 Biwa,再低頭看卡套,視線繼續落到地上的門卡,神情從無奈轉為明白。」
EP1 Shot 1,原片 16–19 秒。這支原片對應較早版本的提示詞,其中寫的是「先看biwa、再看手中卡套上的號碼」。
為什麼紅果短劇在短時間內能吸引這麼多用戶?是劇本癲狂嗎?是模型很厲害嗎? 是的,就是因為模型很厲害,但為什麼厲害?因為各個工作室就是在付了一堆錢給字節跳動之後,知道怎麼調用模型的能力。
你想要角色偷笑?
提示詞節錄:
Biwa 靠著牆看著門前兩人連按三次失敗,嘴角揚起一抹偷笑。
EP1 Shot 1 的較早生成版本,原片 9–10.5 秒,節錄 Biwa 嘴角上揚的表演。
你想要各種剪輯手段?
這支影片實際送出的提示詞:
0–5 秒|分割畫面(split screen):左格的 Biwa 閱讀文件夾中的文件,右格的 Suseka 低頭看向腳邊的門卡;兩人同時抬眼,隔著中央分割線對視。段末分割結束,回到完整的單一畫面。
EP1 Shot 2,原片 0–5 秒。分割畫面是模型直接生成的;這次也有提供 previz,作為左右構圖、動作與鏡頭的參考。
模型都做得到,歡迎來到 Vibe Video 的年代。
普通人可以開始拍片,也得開始學電影
對小團隊來說,現在最方便的事情,就是有想法可以直接試。Biwa 要偷笑?試一下。兩個人隔著分割畫面互看?也試一下。幾分鐘之後,大家就有一段畫面可以討論,不用繼續在腦袋裡各拍各的電影。
然後麻煩就來了。
模型把偷笑做出來了,但她到底在笑什麼?MeiHua 看了她一眼,觀眾知道這一眼是什麼意思嗎?分割畫面也有了,可是這裡真的需要分割嗎?
這些東西,提示詞裡多加幾個 cinematic 並不會幫你決定。
拿這張門卡來說,我們可以讓 Biwa 先笑再丟,也可以先丟,等 Suseka 低頭時才切回她的偷笑。兩種都能把卡送出去,但觀眾什麼時候看穿她在捉弄人,就不一樣了。要試下一版,至少得先決定自己想改的是哪件事。
便宜的好處就在這裡。小團隊可以把一個想法拍出來,看看哪裡不對,再回去改動作、改 previz、改提示詞。下一版有沒有更清楚,直接把兩段放在一起看。每次試拍都能留下具體的東西,大家也終於可以針對同一個畫面討論。
這時候回頭看電影,問題就會變得很實際。別人怎麼拍一個人捉弄另一個人?為什麼有些反應只留半秒就很好笑,留了三秒卻可能像角色當機?同樣是把東西交出去,哪個機位讓人一眼就看懂,哪個機位只拍到一群人擠在一起?
拿自己的角色試一次,就會知道這些問題有多煩。表演、構圖、節奏,拍的時候要管,到了最後的剪輯還要再管一次。生成出來的段落再完整,放進整支片裡拖了節奏,照樣得剪。
現在普通人確實有條件開始這種練習了。看不懂一個技法為什麼有用,就自己拍一次。拍完覺得很爛,至少這次知道自己要學什麼了。